差价 4 倍,谁才是真主力?GPT-6.2 Astra vs Sol 全栈硬核横评
在 High 推理档位下,用 6 道覆盖前端、数学、后端的实战题横评 GPT-6.2 Astra 与 Sol。两款模型的综合均分几乎打平(9.57 vs 9.53),但在四道工程题里,Sol 的总耗时约为 Astra 的 1.85 倍。
文章目录
GPT-6.2 系列发布后,我最关心的并不是谁在榜单上多领先几分,而是:Astra 和 Sol 的单价差了 4 倍,落到具体开发任务里,差距到底有多大?
截至 2026 年 11 月 19 日,OpenAI 官方定价页的 Standard 短上下文档位中,Astra 输入 / 输出单价为 $8 / $40,Sol 为 $2 / $10(每百万 Token)。(来源:OpenAI 官方定价页 · GPT-6.2 发布介绍)
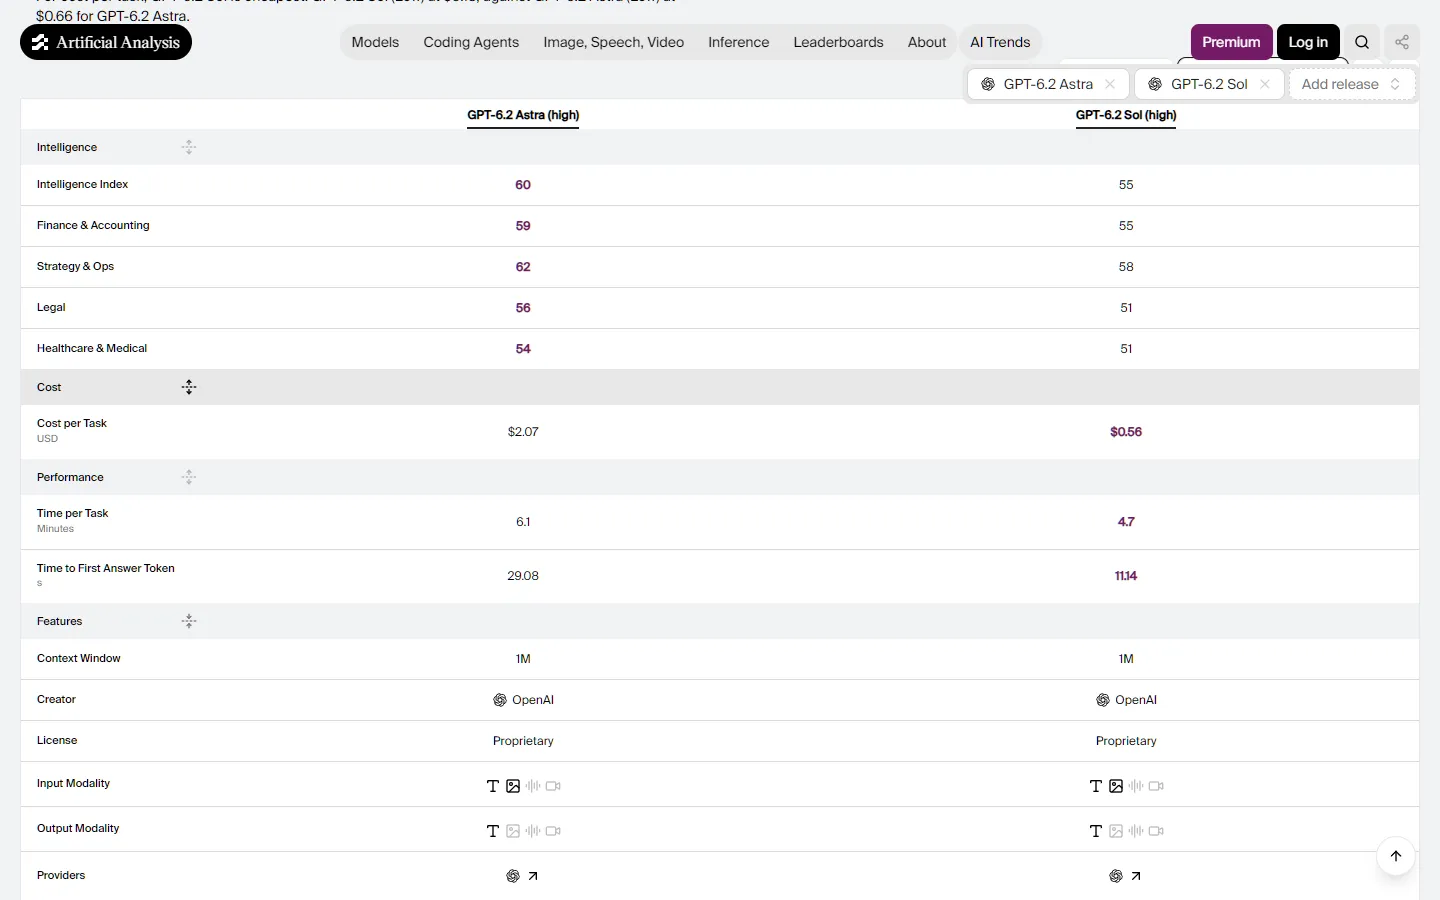
图源:Artificial Analysis 模型对比页(2026 年 11 月 19 日截取,筛选 High 档位)。AA 的数据显示,Astra / Sol 的 Intelligence Index 为 60 / 55,单任务平均耗时 6.1 / 4.7 分钟——在 AA 的题集里,Sol 反而更快。
为了看清真实开发中的表现,我设计了覆盖前端交互、纯数学证明、后端架构的 6 道实战题。两款模型均开启 High 推理档位,使用相同的提示词,允许它们自主调用工具、改代码和跑测试,全程不人工介入修 Bug。最终分数由我人工评定,四道工程题记录从发起任务到最终交付的端到端耗时,两道数学题不计时。
先说最反直觉的结果:在 4 倍单价差下,两者的综合交付质量几乎打平(9.57 vs 9.53);但在本轮四道工程题里,Sol 的总耗时反而是 Astra 的 1.85 倍。
一、总览:6 题得分与耗时对比
| 编号 | 测试题目 | 考察核心 | GPT-6.2 Astra(High) | GPT-6.2 Sol(High) | 本轮胜出 |
|---|---|---|---|---|---|
| F1 | 3D 桌面弹珠物理沙盒 | 渲染、物理防穿模、审美 | 9.5(8分33秒) | 9.0(12分12秒) | Astra |
| F2 | 带“数据陷阱”的薪资看板 | 手写 SVG、识破小样本偏差 | 9.2(5分43秒) | 9.4(12分22秒) | Sol |
| M1 | 二阶导数有界的积分不等式 | 边界连续性陷阱、严格证明 | 9.7(未计) | 9.9(未计) | Sol |
| M2 | 硬币模式博弈与条件期望 | 概率建模、条件期望 | 9.8(未计) | 9.9(未计) | Sol |
| B1 | Go 优惠券并发接口审计 | 事务、并发与异常路径 | 9.8(2分53秒) | 9.3(6分31秒) | Astra |
| B2 | Redis 滑动窗口限流中间件 | Lua 原子性、突发与降级 | 9.4(7分07秒) | 9.7(13分54秒) | Sol |
| 汇总 | 综合均分 / 4 题总耗时 | — | 9.57 / 24分16秒 | 9.53 / 44分59秒 | 质量打平;Astra 更快 |
六题总分分别是 57.4 与 57.2,0.04 分的差距基本可视为打平。评分综合考量了数学严谨度与讲解节奏、前端视觉与可维护性、后端边界覆盖与交付体验。
二、前端实测:极客炫技 vs 教科书级工程
F1:3D 桌面弹珠物理沙盒
题目要求用单文件 HTML 实现倾斜木质弹珠台、5 颗金属球碰撞、3 个弹性碰撞柱、键鼠可控的底部挡板、霓虹反馈和毛玻璃控制面板,支持调节重力、弹性并实时显示 FPS 与碰撞次数。
两份成品都能顺畅运行,但走了两条截然不同的技术路线。
GPT-6.2 Sol(9.0 分,12分12秒) 走的是标准 Three.js / WebGL2 路线,代码结构清爽。物理层面算上了实心球无滑动滚动的 5/7 加速度修正系数,用 240 Hz 定步长加 48 轮约束迭代处理接触,连 webglcontextlost 和上下文恢复也一并补全。
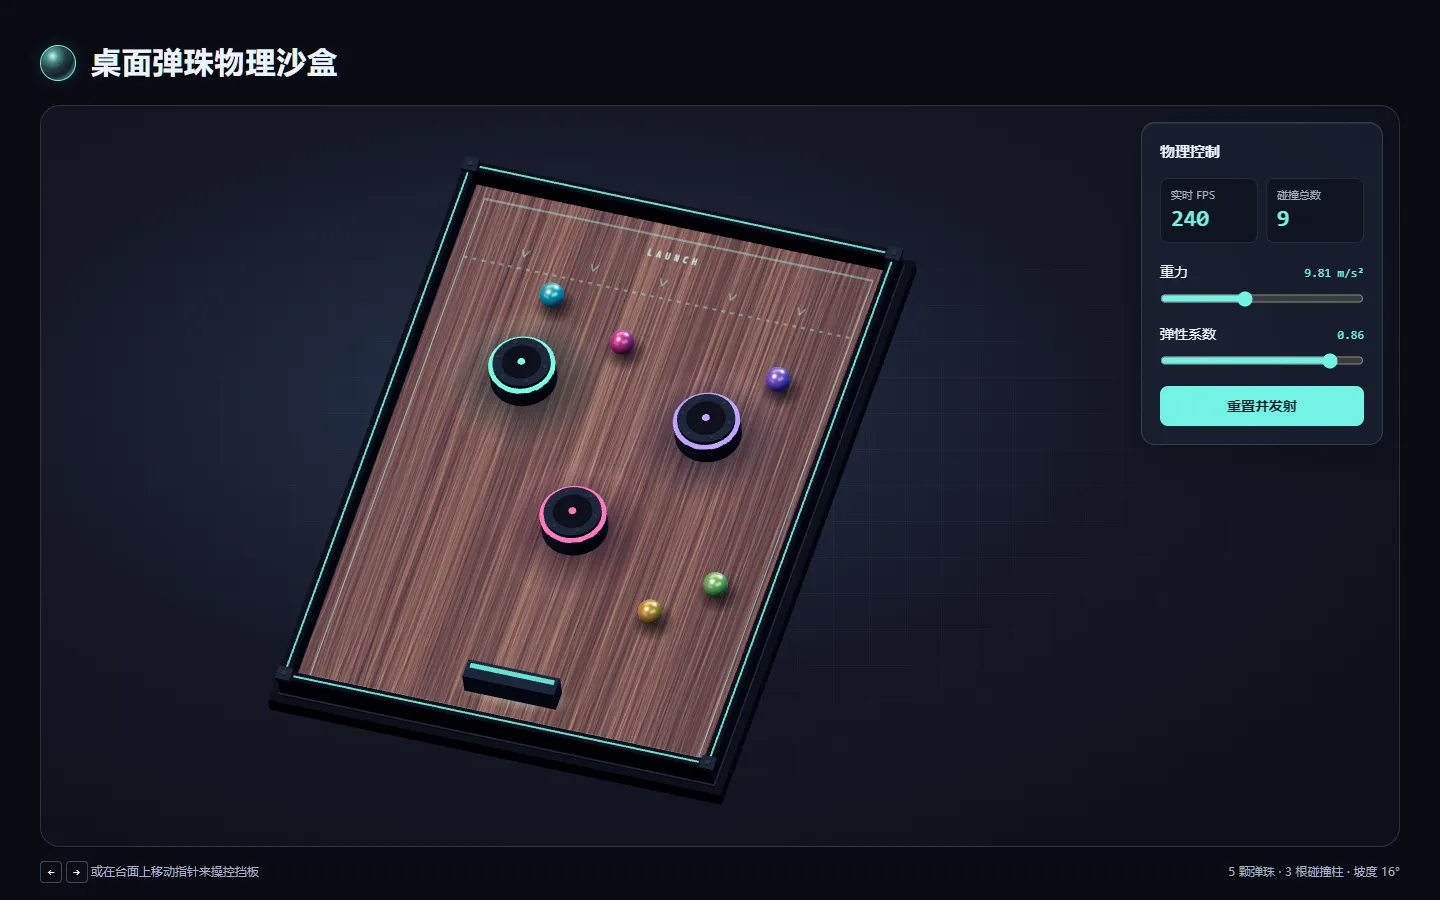
Sol 成品截图(1440 × 900 视口,场景初始化完成后运行约两秒截取)。
GPT-6.2 Astra(9.5 分,8分33秒) 干脆没引入 Three.js,直接用原生 Canvas 2D 手搓出透视投影和立体质感:逐行扫描线映射木纹、画家算法排序、离屏图层缓存,全塞进一个文件。它还自带 FLUX 品牌视觉与可折叠面板,并给碰撞柱和挡板加了街机风格的弹射推力与接触去重。
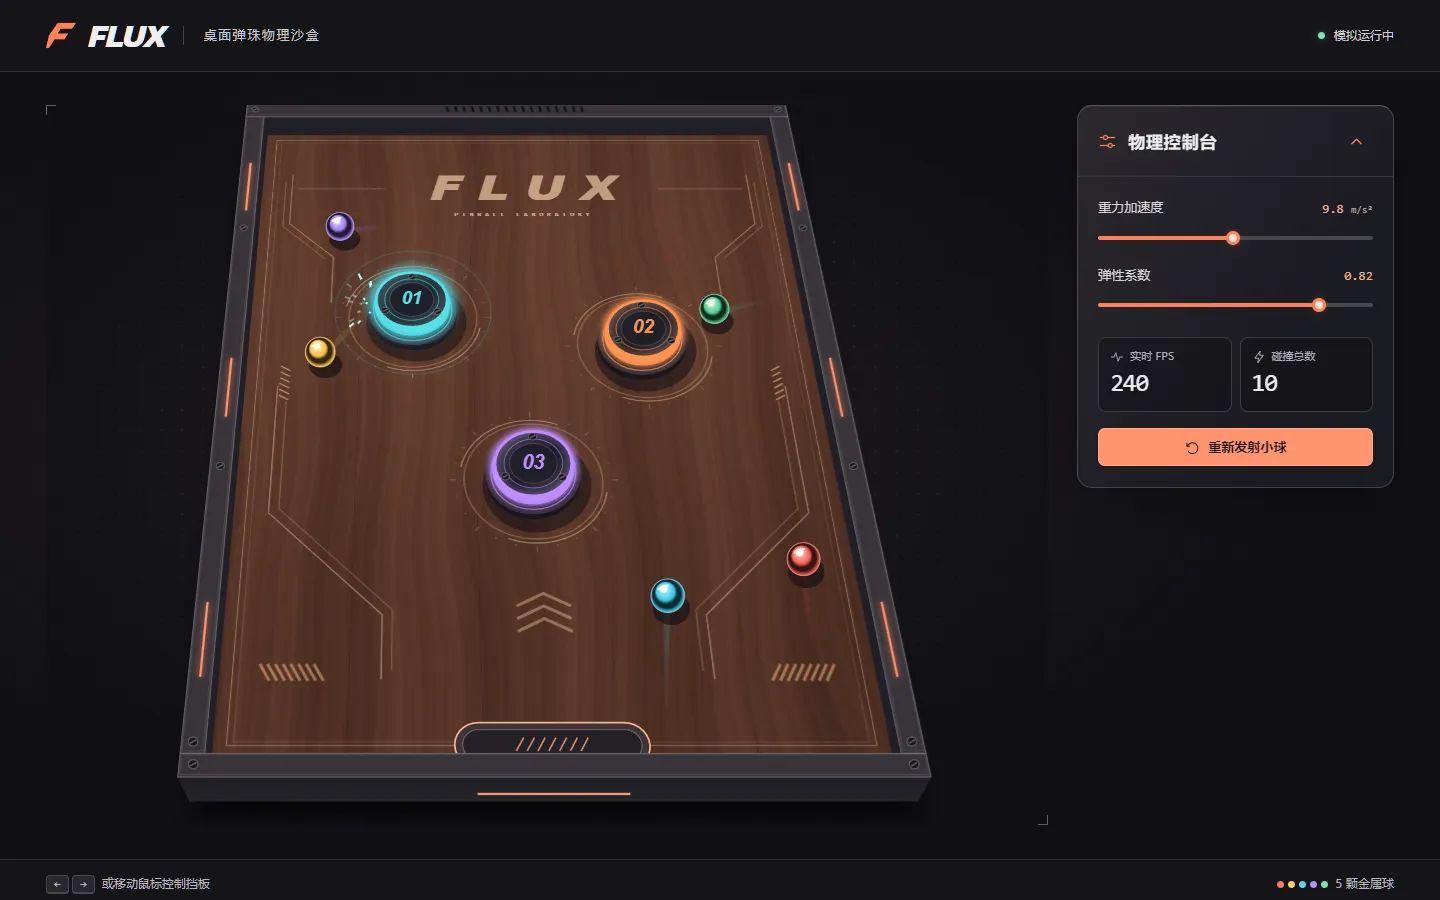
Astra 成品截图(1440 × 900 视口,运行约两秒截取)。
整体包装和手感上我更偏爱 Astra——虽然它用 Canvas 2D 做出的立体视觉和主动注能的弹射更偏向街机模拟,而不是通用 3D 引擎或严格守恒的物理实验,但作为单文件原型,它看起来已经像个能直接拿出去展示的小产品。Sol 的优势在于代码规整,后续二次开发省心。
F2:带“小样本陷阱”的高校薪资仪表盘
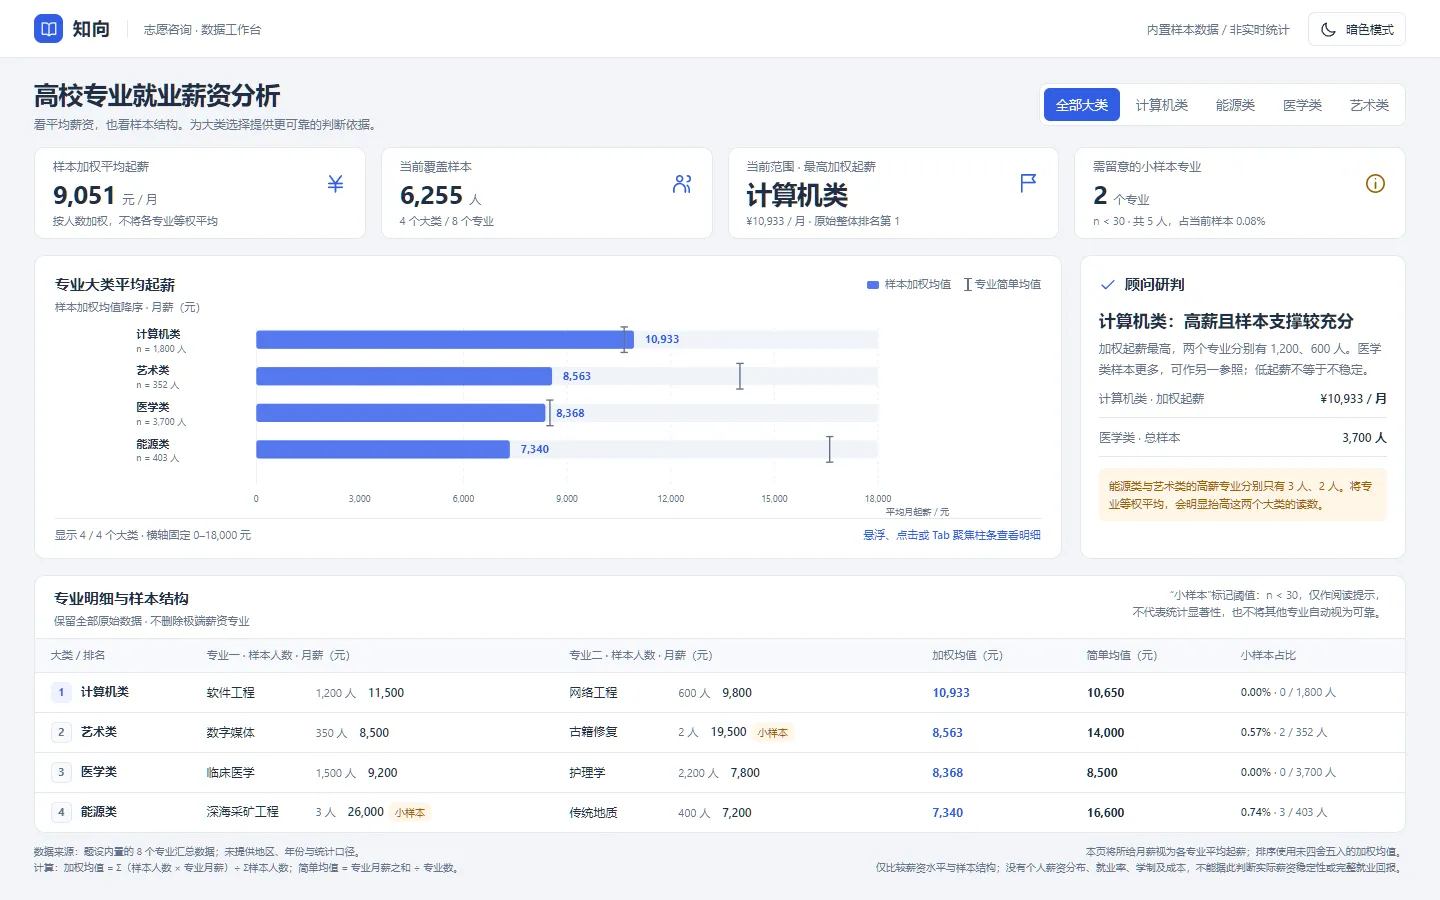
这道题要求不引入任何第三方图表库,纯手写 SVG、CSS 和原生 JavaScript,做一个支持明暗切换、大类筛选、悬浮看明细的薪资看板,在 1440 × 900 视口内一屏呈现。
我故意在能源类和艺术类里塞了深海采矿工程(3 人,月薪 26,000)和古籍修复(2 人,月薪 19,500),看模型会不会被简单平均带偏。
两款模型都识破了样本陷阱,主动改用按人数加权的均值排序,加上了 n < 30 的小样本提示,也补上了“样本量不等于薪资稳定性”的说明。四类排序完全一致:计算机类 10,933 元、艺术类 8,563 元、医学类 8,368 元、能源类 7,340 元(四舍五入)。
Astra(9.2 分,5分43秒) 胜在业务包装与信息密度。页面起名“知向”,四个大类各有独立的顾问研判文案,筛选时指标、图表和明细联动更新。
Sol(9.4 分,12分22秒) 的可视化表达更直给:直接用一条琥珀色虚线把加权均值柱和等权均值菱形连起来,小样本把均值拉偏了多少一眼就能看穿。它还顺手补了 localStorage 主题记忆和 ResizeObserver 响应式重绘。
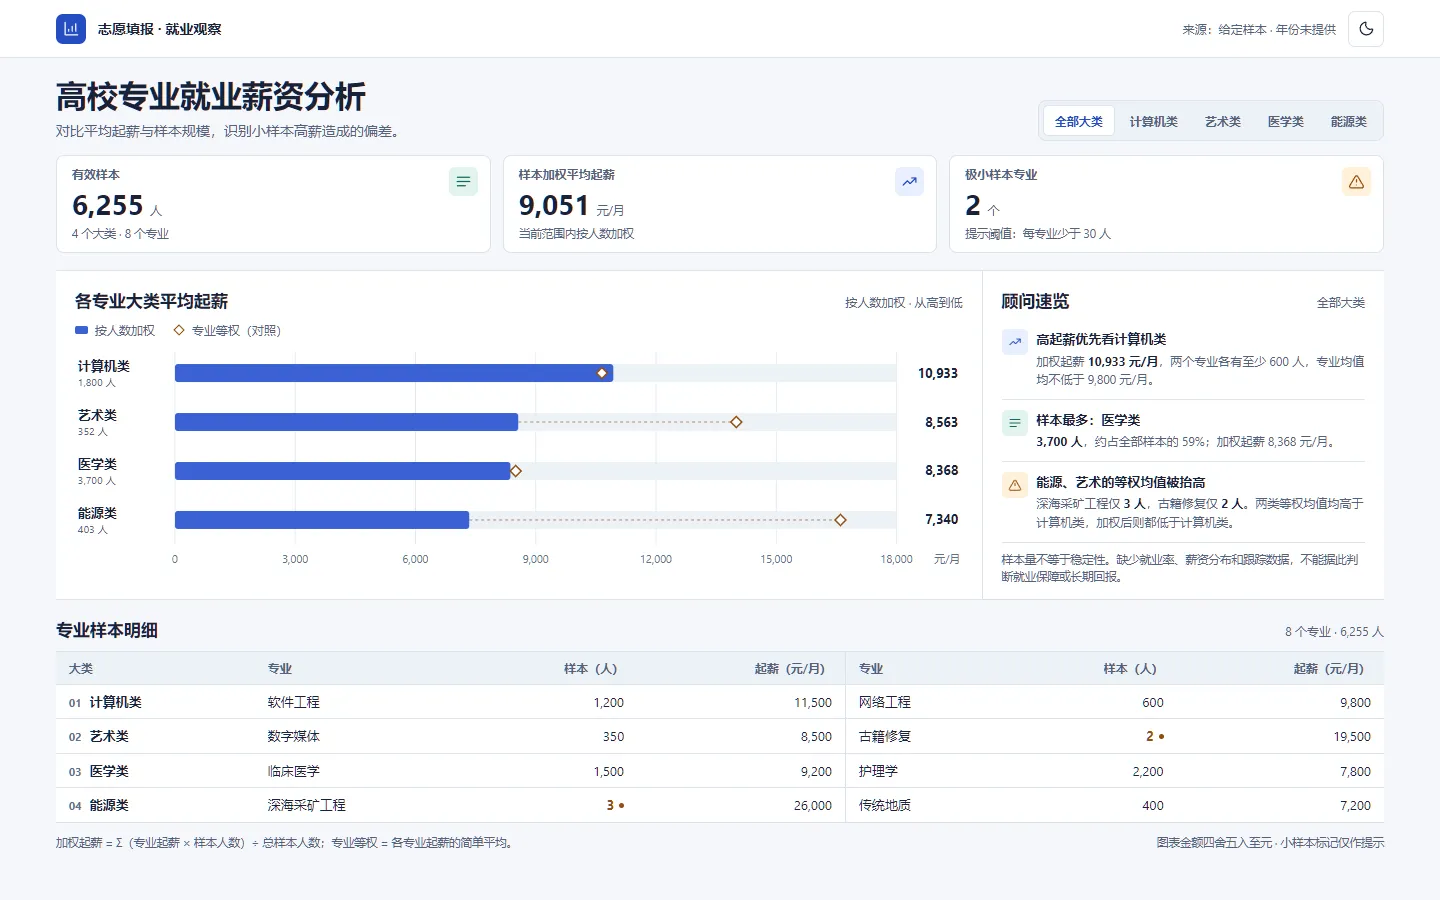
这一题 Sol 略胜一筹,赢在它把“为什么不能只看一个平均数”讲得更直观。
三、数学实测:Sol 的简洁解法更合我口味
两道题分别是含端点连续性陷阱的微积分不等式证明,以及硬币模式 H-T-H 与 H-H-T 的胜率和条件期望。两款模型全数答对,但解题风格迥异。
M1 要求在 f(0) = f(1) = 0、|f″| ≤ M 条件下,证明积分绝对值不超过 M/12,并给出等号函数 f(x) = ± (M/2)x(1-x),再讨论减弱正则性后的情况。
- Astra 走严密通法:主证明用两次分部积分,减弱条件时明确拆成“保留端点连续”和“只指定端点值”两种情况。前者用拉格朗日中值定理证出导数单调性,干净地绕开端点导数;后者用端点取零、内部恒为
M的函数直接反驳。 - Sol 更进一步点出了底层结构:开区间内二阶导有界意味着一阶导满足 Lipschitz 条件,固定内部一点即可推出一阶导有界,从而函数本身在内部也是 Lipschitz 的、必然存在有限单侧极限;反例打破的只是“单侧极限等于端点值”。它还顺带指出了这个 Lipschitz 常数依赖内部点的一阶导,不能单靠
M统一控制。
M2 的三个精确答案分别是:P(H-T-H 先出现) = 1/3,期望投掷次数为 6,已知 H-T-H 获胜时的条件期望为 16/3。
- Astra 列出四状态马尔可夫链,再按获胜概率重加权转移概率(Doob
h-变换思路),并用P(N > 3k) ≤ (7/8)^k补齐了期望有限性证明。 - Sol 则抓住了“等到第一个 H”的更新结构,把状态方程压缩得极为紧凑。两份证明都无懈可击,Sol 的节奏更利落,表达分略高。
四、后端实测:代码审计与限流边界
B1:Go 优惠券并发接口 Code Review
题目是一段简化的 Go 领券代码,里面埋了五个典型隐患:只锁 userID 挡不住不同用户抢同一库存、全局 userLocks 只增不减、UPDATE 失败漏回滚、忽略 COUNT 查询错误,以及 SQL 语句没显式传 ctx。
两款模型全部命中这五个点,而且都挖到了更深层的架构雷区:
Commit()报错时事务可能已经落库,不能盲目回补库存。Unlock()后直接deletemap 里的锁,会让新请求和旧等待者拿到两把不同的锁。- 进程内锁拦不住多实例并发,防重最终要靠数据库联合唯一约束。
- 库存检查与扣减要合并成带条件的
UPDATE,并校验影响行数。 - InnoDB 部分错误只回滚当前语句,应用层仍需主动结束事务。
两款模型对上下文的处理也都很准确:原代码的 BeginTx(ctx, ...) 已经让 ctx 绑定了事务生命周期,但后续查询和更新仍应显式改用 QueryRowContext 和 ExecContext。
- Astra(9.8 分,2分53秒) 直接在回复里贴出了完整的 InnoDB 建表 SQL 和带
*CommitError、errors.Join的现代 Go 修复代码,审阅体验极佳(未跑本地编译和 MySQL 集成测试)。 - Sol(9.3 分,6分31秒) 审计深度不相上下,交付了源码文件,并在本地跑通了 8 个 mock 单测与
go vet。扣分点在交付方式——没把完整修复代码直接贴在正文里,看代码还得额外翻文件。
B2:生产级 Redis 滑动窗口限流中间件
两款模型都交出了完整的 7 文件 Python 项目(ASGI 中间件、Lua 原子脚本、接入示例、依赖文件、文档和 3 个核心单测),均实现了可信用户 ID、规范化路由模板、拒绝请求不续期、429 与 503 区分,以及 Fail-Open / Fail-Close 降级。
- Sol(9.7 分,13分54秒) 的突发流量设计更贴近实战:采用长短双窗口(如 60 秒最多 100 次、1 秒最多 20 次),允许短时脉冲,但不抬高长窗口总额度。Lua 内直接取 Redis 服务端时间,前两个测试直连真实 Redis,还专门起了一个不响应的本地 TCP 端点来实测真实客户端的 50 ms 超时降级。
- Astra(9.4 分,7分07秒) 出活更快、文档详尽。它把突发定义为
limit + burst(比如基础 10 加突发 3,单窗口可放行 13 次),并在文档里坦诚说明这不保证长期速率仍为每窗口 10 次。测试方面,三个核心用例在fakeredis的 Lua 环境下跑通,另补测了真实异步客户端断连时的降级。
两份交付也都点出了上线前的真实边界:Lua 原子性挡不住主从故障切换时的计数丢失,Fail-Open 必然在故障期放宽配额,TTL 也解决不了海量活跃 Key 的内存占用。
五、总结:怎么选?
六道题跑下来,两个模型的性格和适用场景已经非常清楚。
速度:本轮 Astra 快近一倍,但很吃工作流
四道计时的工程题里,Astra 共用 24 分 16 秒(1,456 秒),Sol 共用 44 分 59 秒(2,699 秒),后者是前者的 1.85 倍。工具调用次数、页面加载、测试轮次以及服务端调度都会拉大端到端耗时;结合 AA 榜单上 Sol 单任务反而更快的表现来看,两者的速度优劣很大程度上取决于具体任务和工作流。
风格:产品感原型 vs 规整工程
- Astra 像注重产品感的原型工程师:敢在 F1 直接手搓 Canvas 2D 透视方案,视觉包装完整,交付干脆。缺点是单文件前端爱把代码压得很密,二开前得先整理一遍。
- Sol 像耐心的工程师兼数学讲解者:代码规整,数学直觉敏锐,限流题的长短双窗口设计也更合我意。代价是在这轮工程任务里等得确实更久。
我的选择
- 日常开发、数学推导和后端组件设计:优先用 GPT-6.2 Sol。质量不输 Astra,单价只有四分之一;日常如果不急着拼极限,也可以切到 Medium 档位试探速度与质量的平衡点。
- 需要快速展示、强视觉包装的交互原型:直接选 GPT-6.2 Astra。弹珠台的产品感和整轮工程题的交付速度,用起来更顺手。
至于复杂 3D、大型代码库重构和真实生产排障,留到下一轮更有针对性的测试再见分晓。