新模型发布后,我又跑了一次经典的鹈鹕测试
用经典的鹈鹕骑自行车测试改成 HTML 与 SVG 动画任务,记录 Opus 5.5、GPT-6-Astra 和 GPT-6-Sol 的实际生成效果。
2026 年 9 月 22 日,Anthropic 发布了 Claude Opus 5.5,OpenAI 也发布了 GPT-6 Sol 和 GPT-6 Luna。GPT-6 Astra 则是在 9 月 3 日发布的。新模型一出来,开发者和 AI 博主通常会先找几个大家都熟悉的小题目,快速看看它们写代码和做交互的实际水平。
这次被重新翻出来的,就是“鹈鹕测试”。
它最早是 Simon Willison 提出来的,原始提示词只有一句:
Generate an SVG of a pelican riding a bicycle
它看起来很傻,但并不容易。模型需要同时处理鹈鹕的外形、自行车的结构、骑行姿态和图形代码。这个题目不需要准备数据集,也不需要搭建复杂环境,生成结果还可以直接放到浏览器里看,所以很适合在新模型发布后快速跟测。
从 B 站最近的相关视频也能看出这种传播方式:有人把它做成“30 多个模型同场 PK”,也有人在 GPT-6 Astra 发布后直接做“鹈鹕骑自行车世锦赛”。它已经不只是 Simon Willison 当初的一句提示词,而变成了开发者和 AI 爱好者之间快速比较新模型的一个共同题目。
这次我没有完全照搬原始测试,而是把它扩展成了一个能直接打开的 HTML 文件:
创建一个 HTML 文件,用 SVG 画一只鹈鹕骑自行车的 2D 动画。
要求很简单。页面能直接打开,鹈鹕要真的在骑车,最好还有暂停、重置或速度控制。没有框架,没有素材,也没有提前准备好的 SVG,基本就是把这句话交给模型,看它们会交出什么。
这次我试了 Claude Opus 5.5、GPT-6-Astra 和 GPT-6-Sol。GPT-6-Luna 我也试过几次,但生成结果一直不太理想,所以最后没有把它放进成品对比里。
这次就是一次跟测,重点看文件能否运行、动作是否连贯,以及有没有可用的交互。三份成品不足以排出模型的综合名次,但画面和操作可以直接放在一起看。
先说花了多少钱
这里的价格是我通过第三方中转实际付的费用,不是官方 API 定价:
| 模型 | 档位 | 这次实际花费 |
|---|---|---|
| Claude Opus 5.5 | High | 1.8 元 |
| GPT-6-Astra | High | 0.6 元 |
| GPT-6-Sol | High | 0.06 元 |
看到 Sol 的价格时我是真的愣了一下。0.06 元,连 Opus 5.5 的零头都不到。这种价格差距很容易让人先入为主,所以我还是把三个结果都打开看了一遍,没有只看价格下结论。
Opus 5.5:最像一个完成品
Opus 5.5 给出的页面第一眼就比较完整。
它没有只画一只鹈鹕和一辆自行车,而是顺手补了天空、云、太阳、远山、道路和草地。鹈鹕的嘴、自行车的车轮、脚踏和道路也分得比较清楚。页面下面还有速度控制和暂停按钮。
整体看起来已经像一个可以拿出来展示的小作品,不太像“模型刚刚把要求拼出来”的半成品。
当然,画面丰富也意味着代码和元素更多。对我这种只是想快速验证 SVG 动画的人来说,它有一点用力过猛。再加上这次花了 1.8 元,成本确实不低。
GPT-6-Astra:比较安静的一版
Astra 的画面更轻一些,颜色也更柔和。
它没有塞很多背景细节,海边、草地、太阳和鹈鹕都用比较简单的形状完成了。自行车的结构能看懂,页面也做了暂停和速度控制。
我觉得它比较适合继续改。画面没有 Opus 那么“已经定稿”,但结构相对清楚,想换颜色、改背景或调整动画不会特别痛苦。
不过 Astra 是经过几次尝试后才选到这一版的,所以 0.6 元只是这次记录里的实际花费,不能理解成“一次生成就能得到这个结果”。
GPT-6-Sol:便宜到让我重新检查了一遍
Sol 是这次最出乎意料的一个。
演示更新(2026-10-01):下面的动画已替换为新提供的版本,文中的 0.06 元仍为原测试的花费记录,不代表新版生成成本。
它同样给出了完整场景:天空、云、太阳、草地、道路、自行车和鹈鹕都在。自行车的车架、车轮、脚踏和鹈鹕的动作之间也有基本关系,不是把几个图形放在一起就结束。
我后来又重新打开了一遍,确认它不是截图看起来能动,而是真的能直接运行。页面至少完成了这次任务最重要的部分:一个可以打开、可以观察的 SVG 动画。
而它的实际花费只有 0.06 元。
就这次任务来说,Sol 的性价比最让我意外。0.06 元交出的网页、SVG 和基础交互,并没有因为便宜就明显缩水。
我还看了两类外部对比
看完动画,我又找了厂商资料和第三方对比图,补充了解其他任务的表现。下面这些是外部评估,和上面的生成结果分开看。
Claude 的基准表
下面这张图是 Claude 相关资料中的模型对比表。它把 Opus 5.5、Fable 5.1、Opus 5、GPT-6 Astra 和 GPT-5.6 Sol 放在一起,列了 Agentic coding、知识工作、业务流程、科学研究、电脑操作和图表识别等项目。
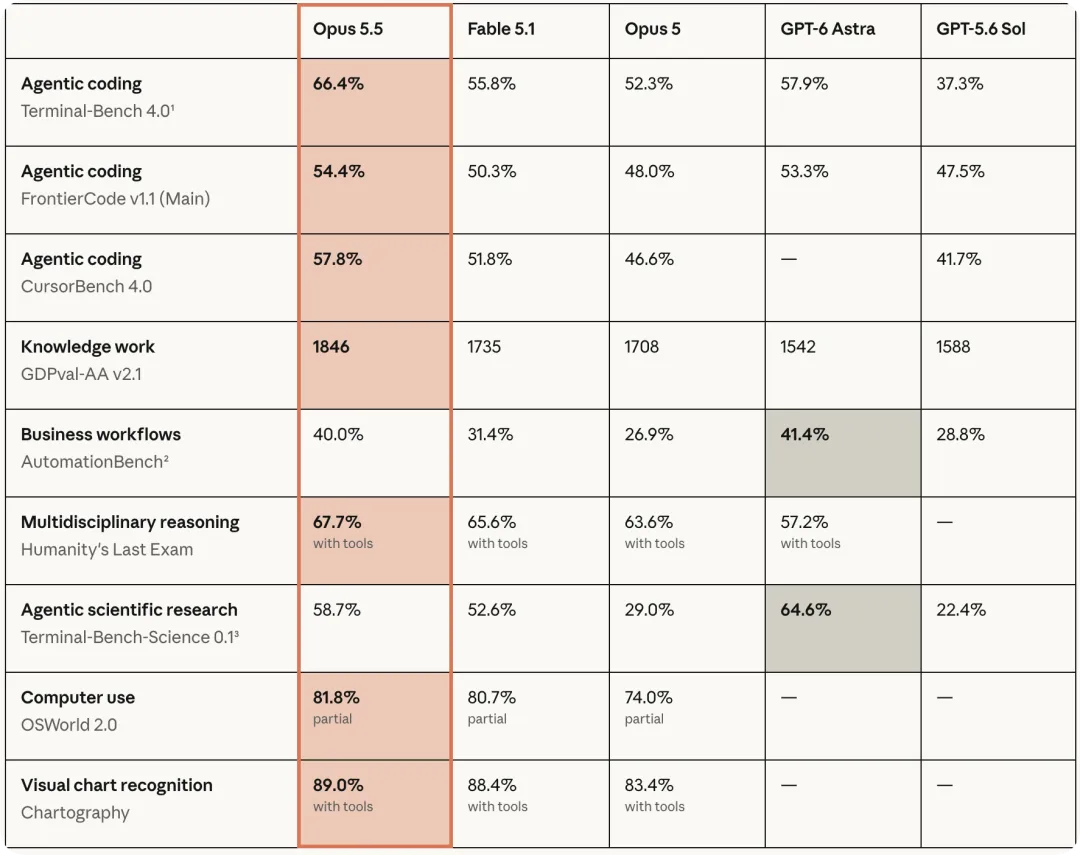
表格里 Opus 5.5 在不少项目中排在前面,但 GPT-6 Astra 在 AutomationBench 和 Terminal-Bench-Science 等项目上也有自己的优势。单看一列分数,很容易把问题想得太简单。不同任务、工具条件和推理档位都会改变结果。
OpenAI 的 FrontierCode 曲线
这张图更接近我关心的事情:不是只看谁分数最高,而是看每个任务要花多少钱,最后能做到什么程度。
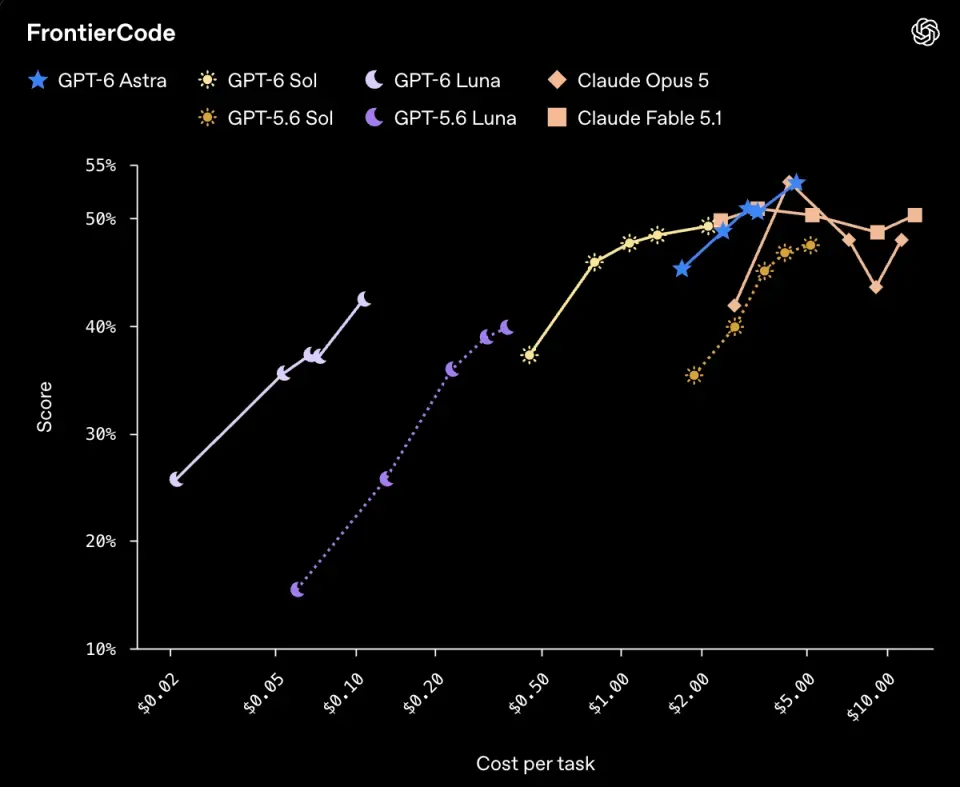
图里不同颜色和符号代表不同模型及推理档位,横轴是单个任务的成本,纵轴是得分。这张图把能力和成本放在了一起。一个模型如果每次都要多轮返工,低单价未必等于低总成本;反过来,如果一次就能把页面做出来,贵一点也可能值得。
我还看了 Artificial Analysis 的模型发布版本对比页。它把 GPT-6-Sol、Claude Opus 5.5 和 GPT-6-Astra 放到同一个页面,并区分了不同推理档位,提供 Intelligence Index、速度、延迟和成本等指标。
参考页面:Artificial Analysis 模型发布版本对比。
这个页面的排名和数据会变化,所以我只把它当作当天的参考,不把它当成最终答案。
这次我实际在看什么
我并不是只看画面好不好看,主要看了下面几件事:
能不能理解画面
“鹈鹕骑自行车”需要同时处理动物姿态、自行车结构、前后景和画面比例。只会画鹈鹕,或者只会画自行车,都不算完成。
能不能真的跑起来
最后交付的是 HTML 文件,不是聊天窗口里的一段代码。文件能不能直接打开,动画有没有报错,按钮能不能用,这些比模型自己说“已经完成”重要。
动画是不是连在一起的
车轮转了不代表鹈鹕在骑车。脚踏、身体、车轮和车架之间至少要有一点配合,否则看起来只是几个 SVG 元素分别在动。
生成结果要不要返工
这次最影响体感的其实不是某个分数,而是“拿到结果后还要改多久”。Opus 5.5 的第一版完成度很高,Sol 的成本低得离谱,Astra 则比较适合当作继续修改的底稿。它们各自的优点不在同一个方向上。
最后怎么选
如果我想快速做一个能展示的页面,我会优先试 Opus 5.5。
如果我想要一个结构清楚、方便自己继续改的页面,Astra 会更舒服。
如果任务边界比较明确,又不想在一次小实验上花太多钱,Sol 很值得先试。至少这次,它用 0.06 元交出了一份让我愿意留下来的结果。
按这次的使用感受,我会这样选:
- 完成度:Opus 5.5
- 可修改性:GPT-6-Astra
- 价格带来的惊喜:GPT-6-Sol
这只是我在 2026 年 9 月 23 日做的一次小测试。模型会更新,接口会变,第三方中转的价格也会变。以后再做类似任务,我大概还是会先让便宜的模型跑一遍,遇到真正复杂的部分,再考虑换更贵的模型。
参考资料
- Claude Opus 5.5 模型概览
- Claude Opus 5.5 System Card
- GPT-6-Sol 与 Luna 介绍
- GPT-6-Astra 介绍 经典测试的原始提示词和模型样例可以参考 Simon Willison 的 pelican-bicycle 仓库。我这次使用的是它的扩展版:要求模型输出完整 HTML,并加入 SVG 动画和基础交互。上面的三个演示就是各自生成的原始 HTML,可以直接操作,也可以独立打开,比较动画和交互效果。