DeepSeek V4.1 Flash-1017 能否媲美 GPT-5.6 Sol?三组前端任务的实际对比
对比两款模型在会议官网、三主题香水品牌和 Canvas 锦鲤池中的成品、交付时间及 API 用量,并提供六份作品的点击体验入口。
DeepSeek V4.1 Flash 1017 发布后,我想验证一个具体问题:它与 GPT-5.6 Sol 的差距,落到实际前端开发里还有多大?
我关注的是两者能否完成同一类任务,以及成品、用时和交付过程有什么不同。这篇文章围绕三组作品展开,也结合官方公布的基准数据,讨论“媲美”这一判断能成立到什么程度。
为什么拿 GPT-5.6 Sol 来对比
下面是 DeepSeek 随 1017 版发布的官方能力对比图,蓝色列对应本次测试的版本。
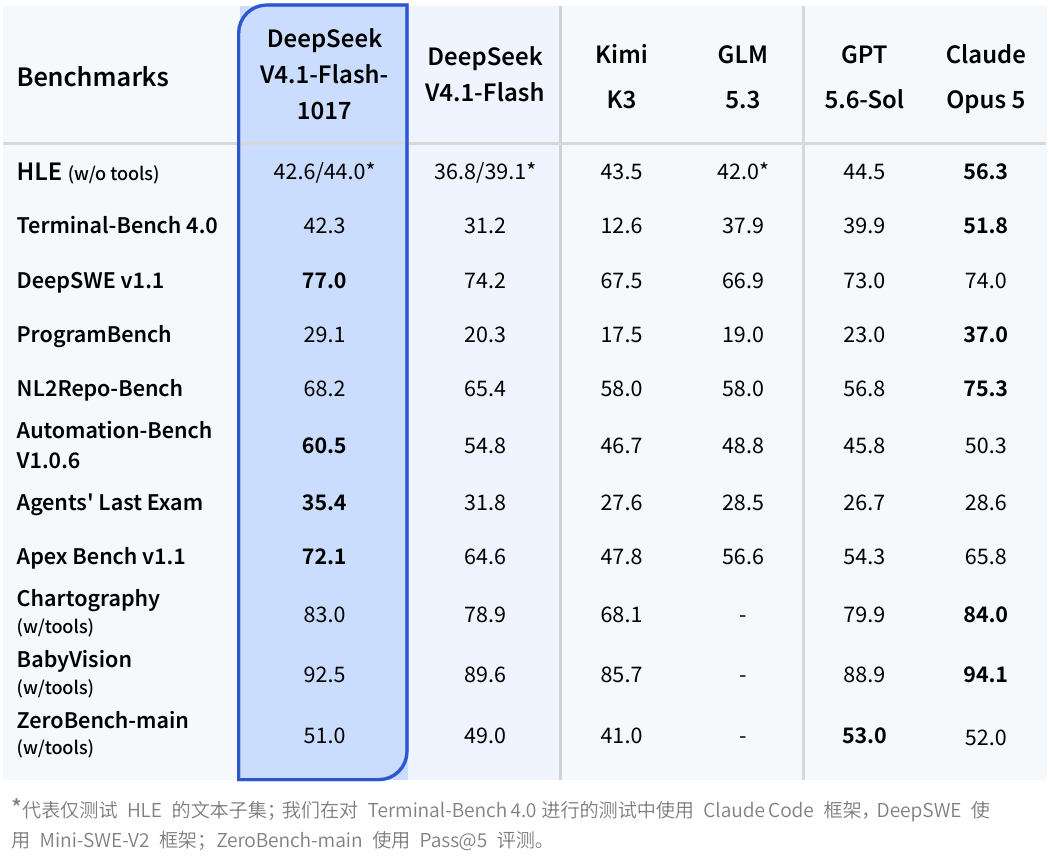
图源:DeepSeek 2026 年 10 月 17 日发布说明。数据为发布方评测;图中 HLE 带星号的成绩仅对应文本子集,不能与完整测试成绩混用。
截至 2026 年 10 月 19 日,DeepSeek 的 1017 官方模型卡已将新版与 GPT-5.6 Sol 列在同一张评测表中。以下均为 DeepSeek 官方公布的分数,前者为 DeepSeek,后者为 GPT:
- Terminal-Bench 4.0:42.3 对 39.9。
- DeepSWE v1.1:77.0 对 73.0。
- ProgramBench:29.1 对 23.0。
- NL2Repo-Bench:68.2 对 56.8。
- HLE 无工具:42.6 对 44.5。
前四项 DeepSeek 较高,最后一项较低。模型卡注明 Terminal-Bench 使用 Claude Code,DeepSWE 使用 Mini-SWE-V2;这些设置与本文的两套开发工具不同。上述数据属于发布方评测,不能当作独立复测结果,也不能直接换算成前端设计分数。来源:DeepSeek 1017 官方模型卡
官方发布说明还强调了从零构建完整项目的能力,以及相对上一版缩短任务时间与输出长度的改进。这里的速度比较对象是上一版 DeepSeek,不能读成“比 GPT-5.6 Sol 更快”。来源:DeepSeek 2026 年 10 月 17 日更新说明
这些资料构成了本次对比的起点:DeepSeek 在部分编程与 Agent 基准上已经有相当强的表现,那么面对开放式网页设计,它能否把这种能力转化为完整、可操作的成品?
1017 版的 Flash 应当怎样理解
本次使用的是 2026 年 10 月 17 日更新的 V4.1 Flash-1017。其发布仓库的配置列出了 40 层语言网络、每层 384 个路由专家、每 Token 选择 6 个路由专家,以及 1,048,576 的最大位置长度。来源:1017 版官方配置
基础架构的解释来自 V4.1 Flash 技术报告:552B 骨干参数,另有约 196B Engram 条件记忆参数;采用因果编码器—解码器结构,预填充阶段每 Token 激活约 8B 参数,解码阶段约 16B。报告中的 890 bytes/token 指全局 KV 缓存占用,不是模型全部运行内存,也不能与持久化缓存混为一谈。来源:V4.1 Flash 技术报告
这些信息有助于理解它降低输入处理与缓存成本的设计方向。本文的成绩仍全部取自 1017 模型卡,9 月技术报告只作为架构背景。激活参数少不等于整个模型只有 8B 或 16B,也不能直接推出它必须靠更多迭代才能完成任务。
本次怎样比较
DeepSeek 使用 DeepSeek Harness Desktop,模型为 V4.1 Flash-1017,推理档位 Max;GPT 使用 Codex,模型为 GPT-5.6 Sol,推理档位 High。三组任务分别是会议官网、三主题香水品牌和 Canvas 锦鲤池,均要求原生 HTML、CSS、JavaScript 的单文件实现。
本文展示的是各自最终提交的版本。部分任务先生成英文版,再改为中文版,用时会将两个阶段一起记录。由于 Harness、推理档位和修改流程不同,这是一组实际工作流对比,无法单独隔离模型自身的影响。
检查使用了 1440 × 900 的桌面视口和 390 × 844 的手机视口,并结合源码检查议程、报名、主题切换、购物袋和动画控制。截图中的设计判断带有个人审美偏好;关键交互则根据实际操作结果描述。提示词保留本次任务材料中的完整文本,不包含各工具额外加载的系统指令、Skill 和后续修改要求。
页面入口仅在点击后打开,阅读本文不会提前加载六份交互作品。
第一组 维修主题会议官网
在线体验(新标签页打开):DeepSeek 版会议官网 · GPT 版会议官网
这道题的关键,是能不能把“维修与维护”变成具体的设计语言。会议属于桥梁检测员、夜班机械师和医疗设备工程师,页面应该让人感受到这个主题。
给模型的提示词如下。
你是一名顶级创意前端工程师兼视觉设计师。

请在当前工作目录创建一个完整、可运行的单页网站,主题是:

STILL RUNNING — 一场关于维修、维护与让世界持续运转的三日设计会议。

这不是普通的科技发布会,而是献给桥梁检修人员、夜班机械师、医院医疗设备工程师,以及所有维护基础设施的人。

设计目标:
让它看起来像真正获得 Awwwards 认可的创意工作室作品,而不是常见的 AI 生成模板。

必须包含:
1. 极有视觉冲击力的 Hero 首屏,会议名称、日期、地点、报名按钮清晰可见
2. 会议理念介绍与富有设计感的数字、标语排版
3. 三日议程,可切换日期查看演讲及工作坊
4. 嘉宾介绍,至少 6 位,使用真实感较强的虚构资料
5. 票务信息与报名弹窗,表单需验证输入
6. 完整页脚与移动端导航

视觉要求:
- 以工业设计、建筑图纸、维修手册、现代瑞士平面设计为灵感
- 使用富有个性的字体、非对称网格和大胆留白
- 细致处理数字、细线、边框、卡片层次
- 不要使用千篇一律的渐变 Hero 加三个功能卡片
- 交互元素具有进入、悬停及退出动画
- 关键区域使用连续、自然的形变或共享元素过渡
- 支持 prefers-reduced-motion

技术要求:
使用原生 HTML、CSS 和 JavaScript,全部放在一个可直接打开的 index.html 中。不使用外部框架、CDN 或图片生成 API。视觉图形可以由 CSS 或内联 SVG 创建。

支持桌面端和手机端。所有按钮、日期切换、菜单及报名表单必须实际可用,不接受纯视觉假交互。

直接创建文件,完成后检查页面与脚本,并简要报告实现情况。
DeepSeek 的版本以“仍在运转”为中心,用很大的中文标题、偏灰的纸色、深绿色文字,以及少量橙红色强调,构成一种工程档案的气质。底层网格、细线分区和编号让页面有很强的秩序感。
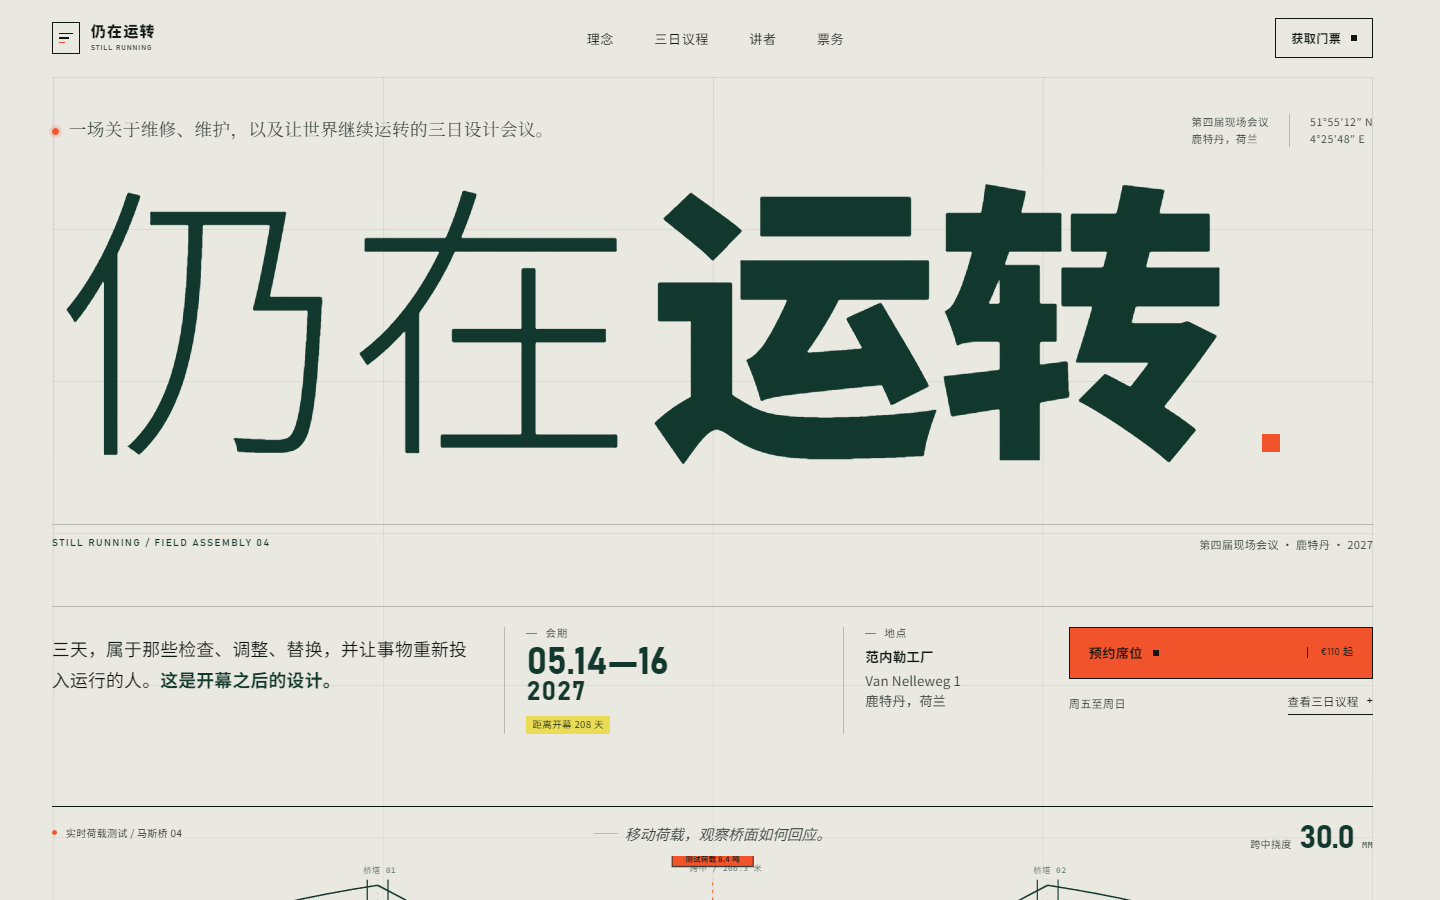
DeepSeek 把主题延伸到了交互里。首屏下方有一座桥梁荷载演示,源码将滑块位置与桥面曲线、挠度数字关联起来。这是为了展示主题而设计的形变效果,没有依据将它称为经过验证的工程力学模拟。
它还提供了八位讲者的档案,并在源码中实现了报名信息本地保存和 .ics 日历下载。日历生成逻辑处理了 UTF-8 字节长度与折行,这属于细致的实现;本文没有做完整的日历标准兼容性测试,因此不把它描述成“严格通过 RFC 5545 验证”。
GPT 走的是白、黑、亮蓝的方向。英文 STILL RUNNING 占据首屏主要位置,右侧用圆环和“03”形成视觉中心,日期、地点、语言、席位则整理在清楚的信息区里。
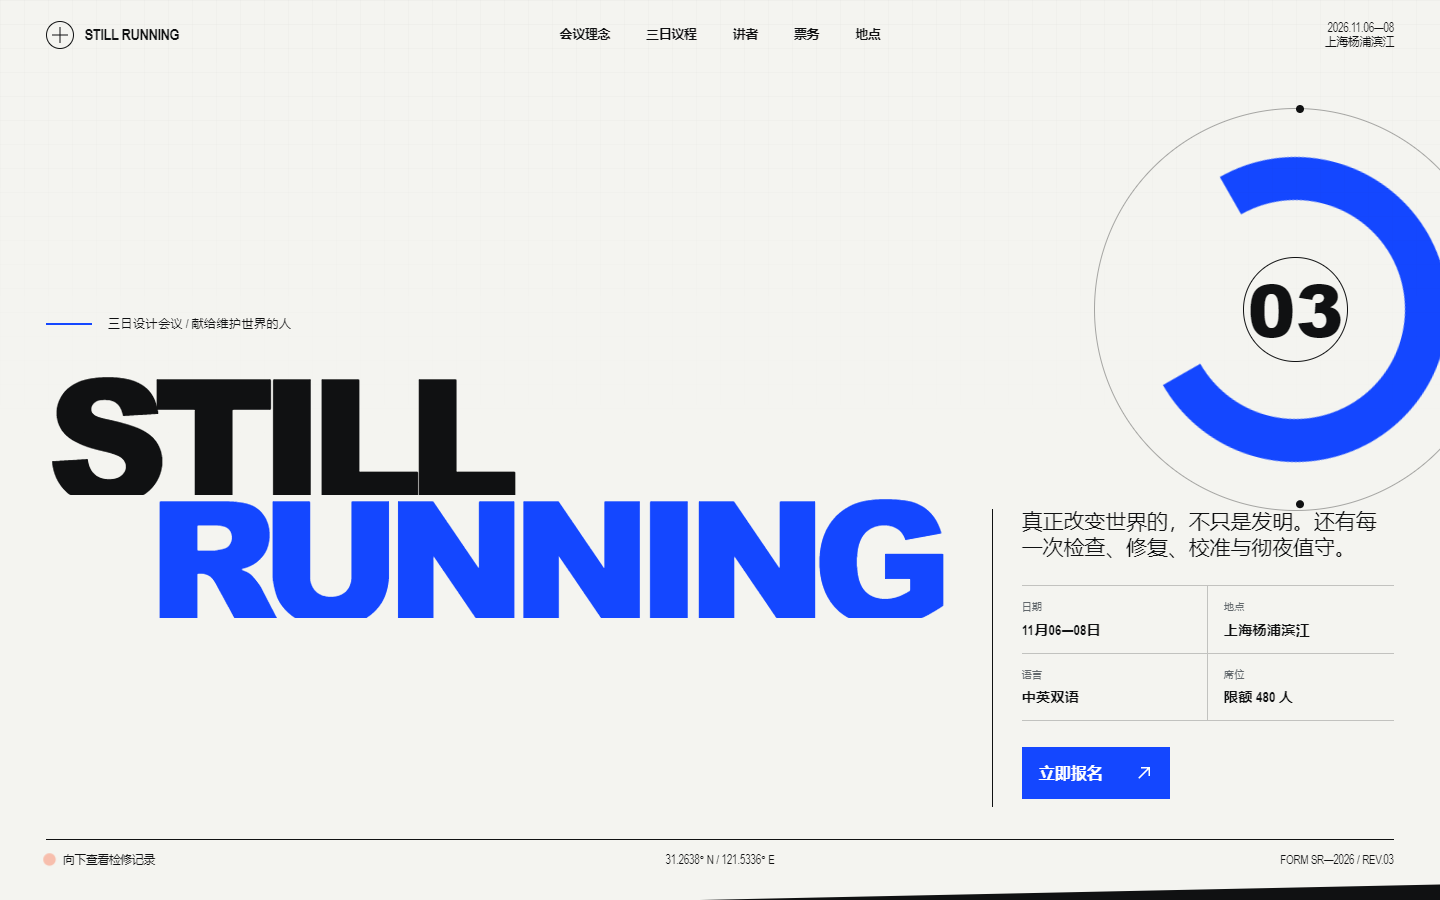
如果只看首屏,我会把 DeepSeek 理解为一本被搬到网页上的维护手册,把 GPT 理解为一张现代设计会议海报。两者都回应了题目,也没有退回到常见的渐变背景加功能卡片。
功能方面,两边的第二日议程都能实际切换,报名弹窗也能打开。直接提交空表单时,两边都会阻止进入成功状态;填写测试姓名、邮箱和必要选项后,都能走到演示确认页。
这里有个小细节值得单独说。DeepSeek 的成功页生成了确认编号,并明确写明资料只保存在本浏览器,没有付款,也不会发送邮件。GPT 的成功页却提示“确认邮件与付款链接将发送至”所填邮箱,而源码没有对应的邮件发送逻辑。
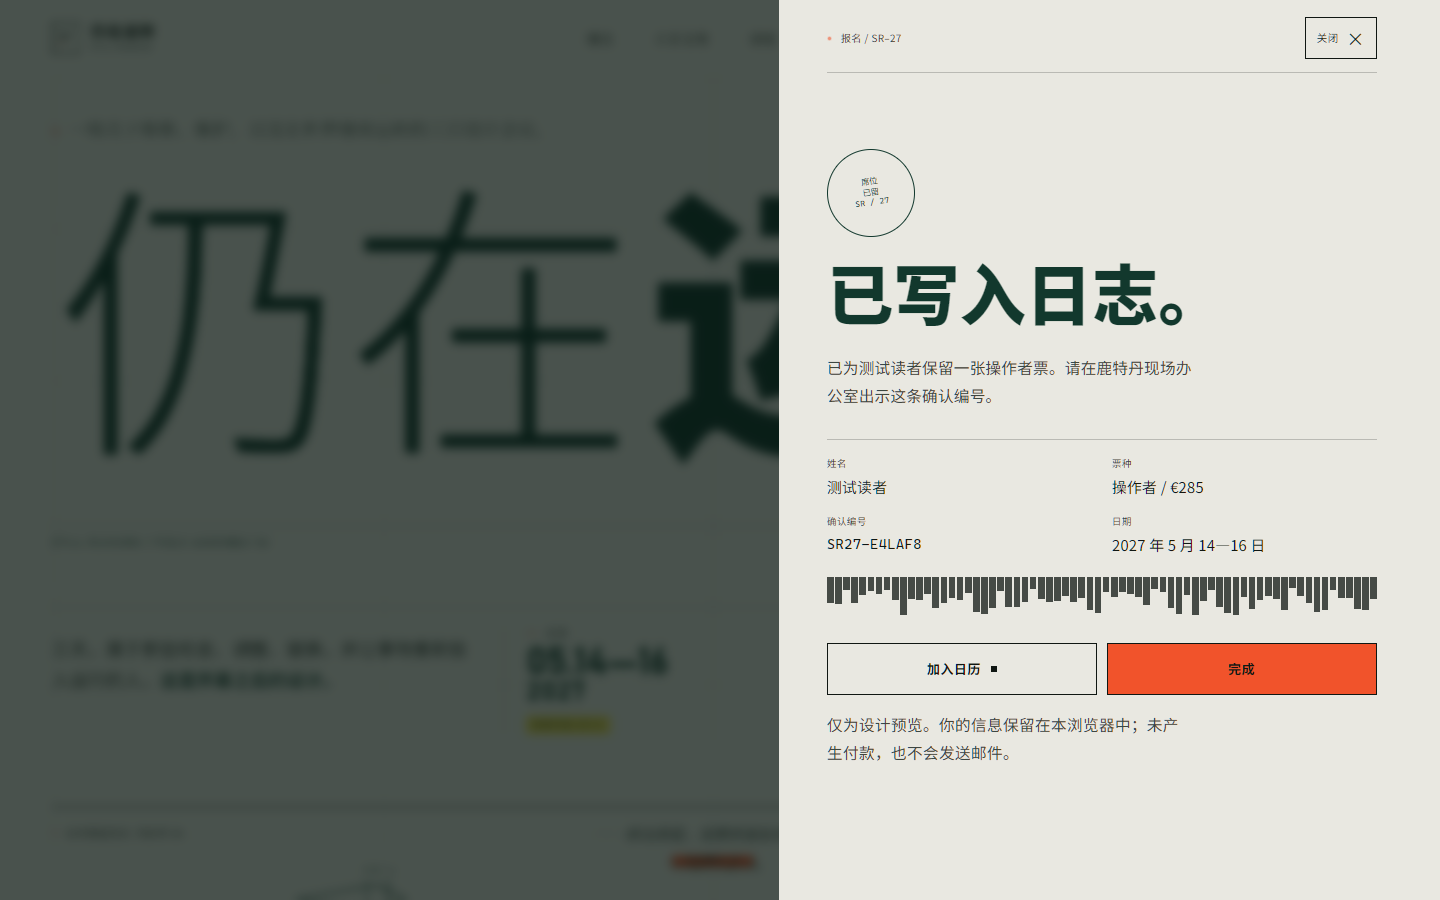
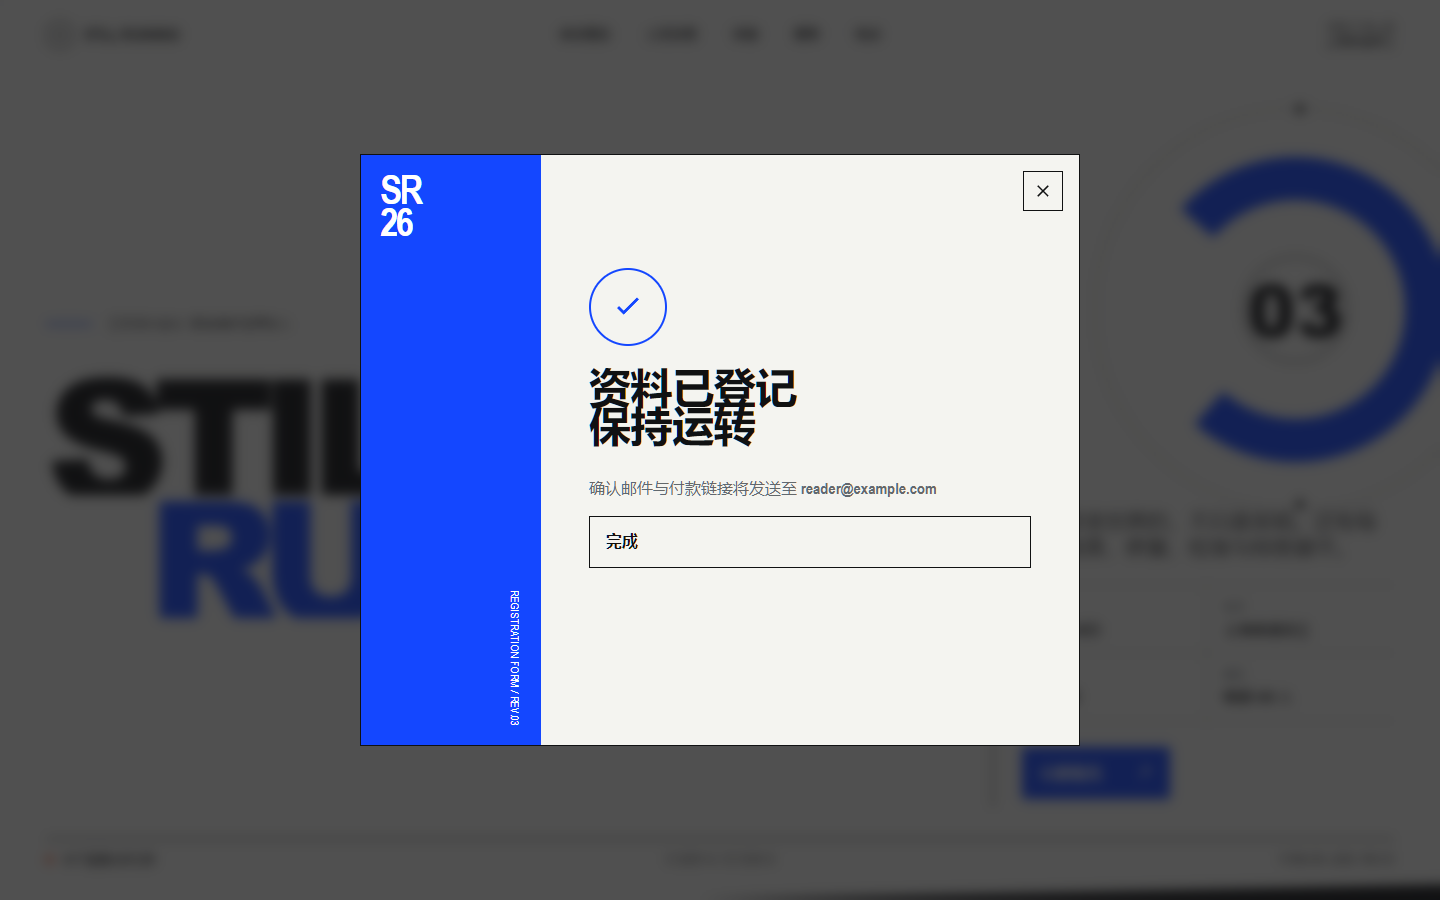
这不影响它作为前端原型展示流程,但会影响用户对功能完成度的判断。演示成功状态和真正完成报名,应该在文案上区分清楚。
手机首屏中,两边都重新组织了信息,截图没有出现页面整体横向溢出。DeepSeek 保留了档案式的信息密度,GPT 则给标题和日期信息留出了更多空间。不过,视口截图只能说明当前尺寸的表现,还不能代替真实手机上的全面检查。
在这组提交版本中,我更偏向 DeepSeek 的主题表达。GPT 的首屏同样有清楚的识别度,DeepSeek 则在会议内容之外增加了更多与维护主题相关的交互。
第二组 同一个香水品牌 三种视觉系统
在线体验(新标签页打开):DeepSeek 版香水品牌 · GPT 版香水品牌
这一题比单纯做一个漂亮官网更难:内容保持一致,视觉系统却要发生实质变化。同时,主题切换不能把当前商品和购物袋状态一起清空。
提示词如下。
创建一个名为 ORDINARY HOURS 的高端独立香水品牌官网。

最重要的挑战:
在同一个网页内设计三套真正不同的视觉系统,而不仅是改变背景色。

三个主题:

A. EDITORIAL
灵感来自欧洲独立时尚杂志。
奶油白、黑色、优雅的衬线字体,大幅留白,克制、奢华。

B. EXPERIMENTAL
灵感来自先锋平面设计与数字艺术。
大胆的不对称排版、超大字体、高对比颜色、几何构图,具有强烈实验性。

C. NOCTURNE
灵感来自深夜、高级香氛与电影摄影。
深黑、冷蓝、微弱金属光泽,极富层次的暗色美学。

网站包含:
- 品牌首页和导航
- 三款香水的产品展示
- 香调金字塔展示,包括前调、中调、后调
- 品牌理念
- 产品详情弹窗
- 可交互的加入购物袋功能
- 三个主题的切换控制器

关键要求:
1. 切换主题时,字体、排版、间距、装饰图形、颜色和组件形态都应变化
2. 切换不能闪屏,使用连贯的 Morph Transition 风格动效
3. 切换主题时保留当前展示的产品、购物袋数量及页面状态
4. 商品图片可采用原创 CSS、SVG 香水瓶插画,不使用外部图片生成服务
5. 三个主题都必须具有独立的设计品质,不能只精心制作其中一个
6. 移动端同样支持完整主题切换

请以原生 HTML、CSS、JavaScript 编写单文件可运行作品。

完成后验证三个主题能正常切换,并检查交互及响应式布局。
默认的杂志主题中,两边都采用了暖白底色、衬线字体和较多留白。
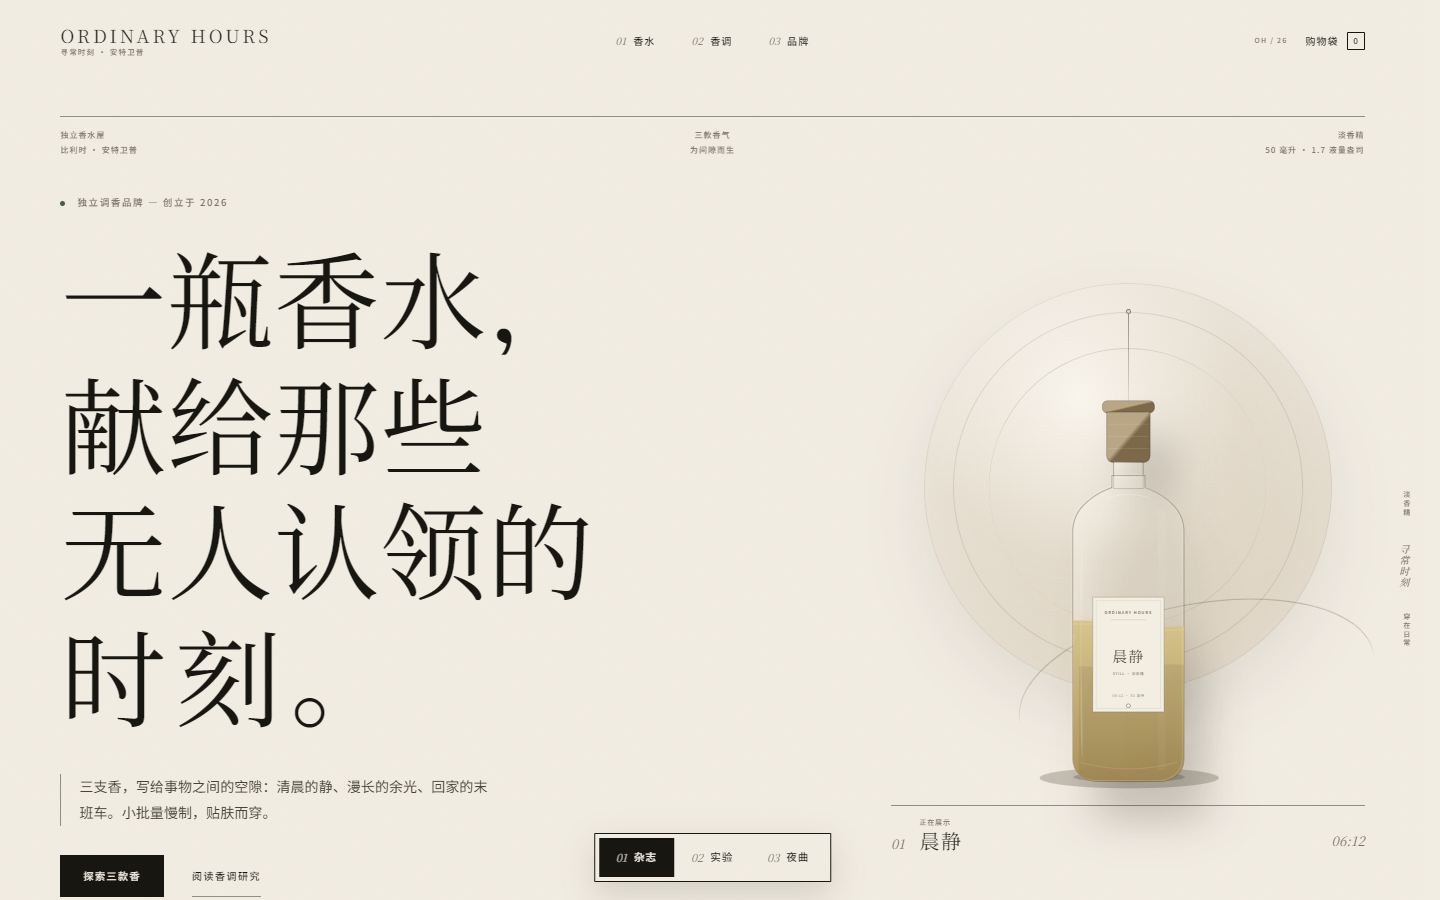
DeepSeek 把中文文案做成了主角,“一瓶香水,献给那些无人认领的时刻”占据左侧,右侧放一支细长的香水瓶。字体、瓶身和细线圆环组成的画面比较安静。
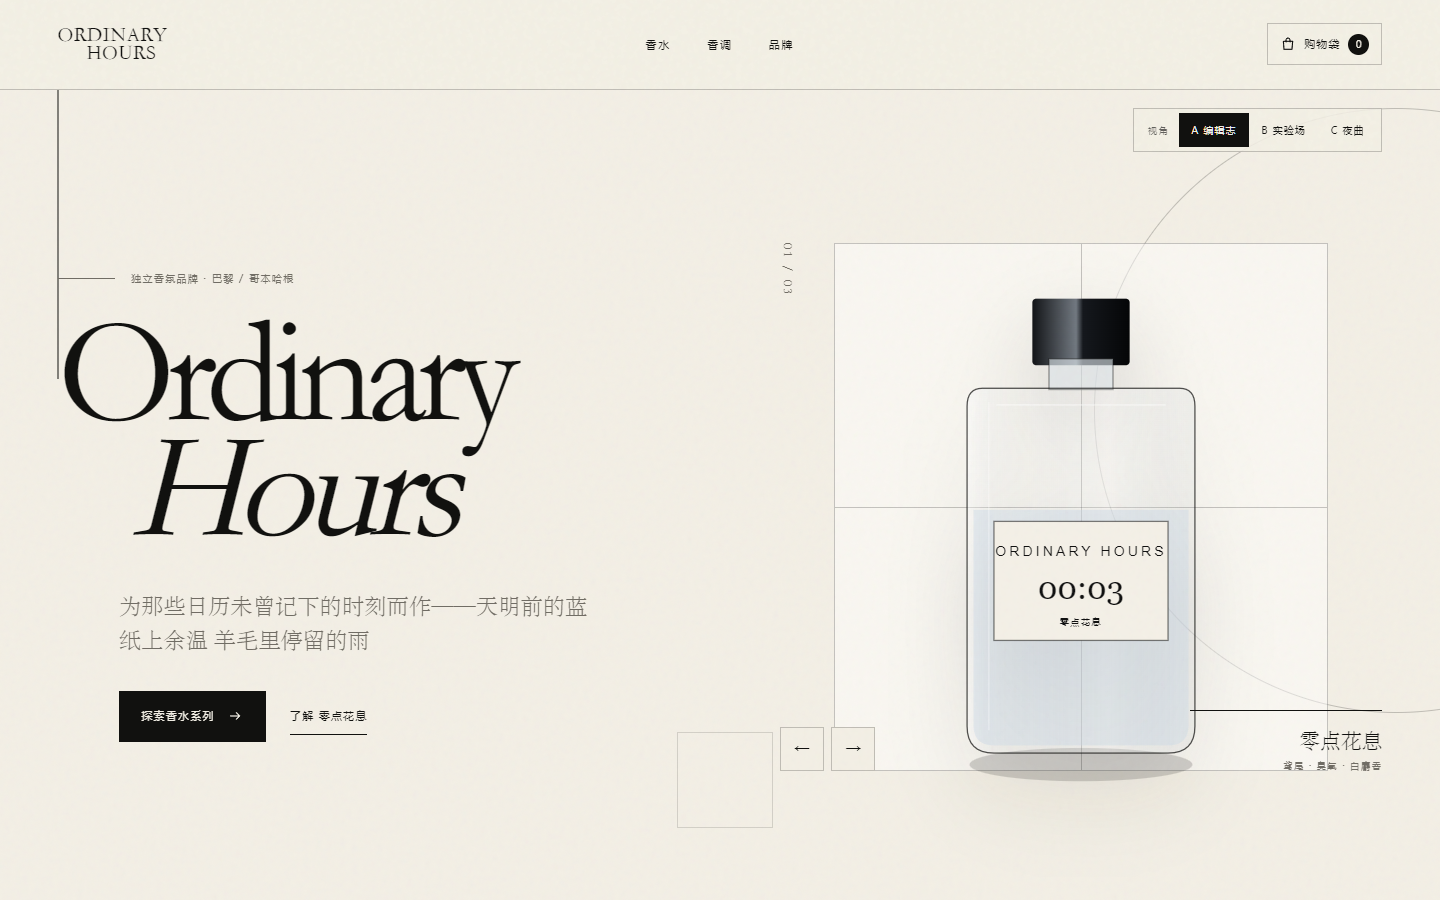
GPT 则把 Ordinary Hours 的英文品牌名放得更突出,右侧是一支宽一些的透明香水瓶,配上细线框和产品切换按钮。相较之下,它更接近以品牌标识为中心的独立香氛网站。
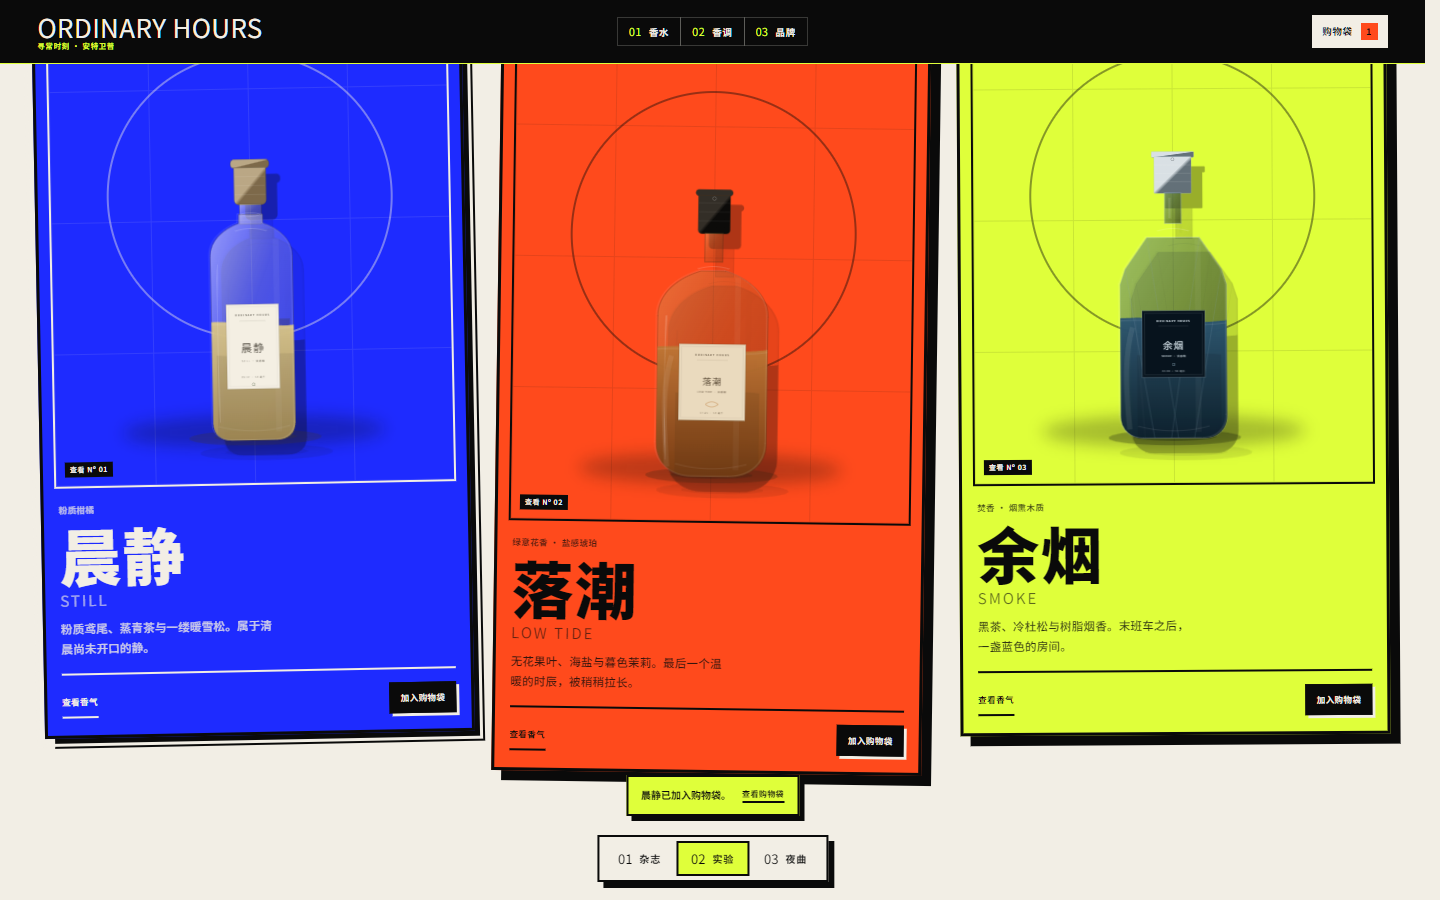
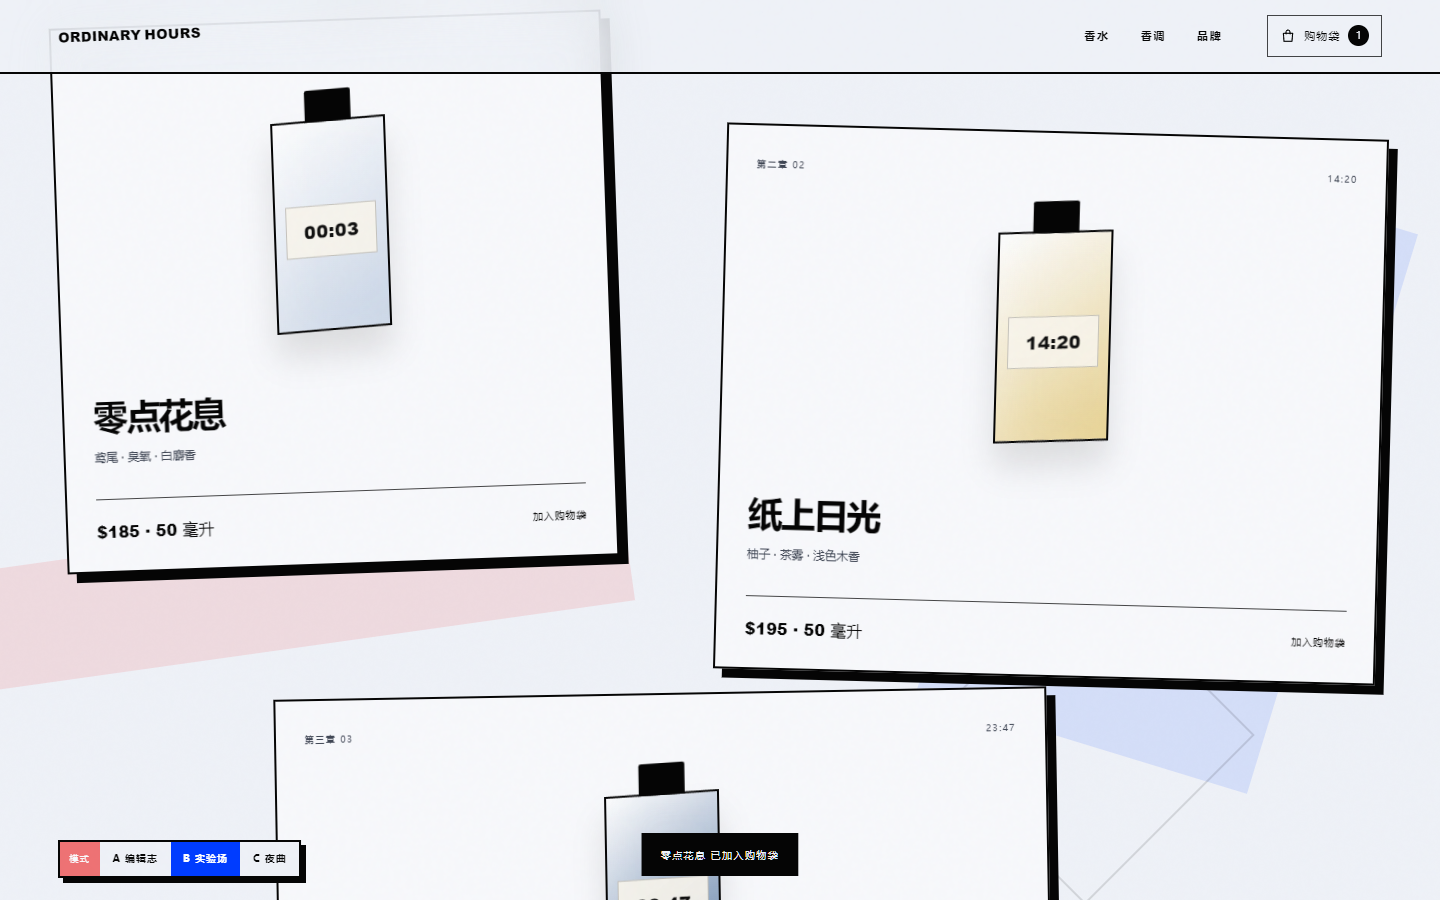
切到实验主题,两边都确实改变了布局和组件形态。DeepSeek 使用蓝、橙红、荧光黄绿的大色块、粗边框和倾斜卡片;GPT 同样使用错位排布、黑色硬阴影和更强的无衬线字体,但大面积背景依然比较克制。
以下两张截图位于商品区,用来观察主题对商品卡片的影响。
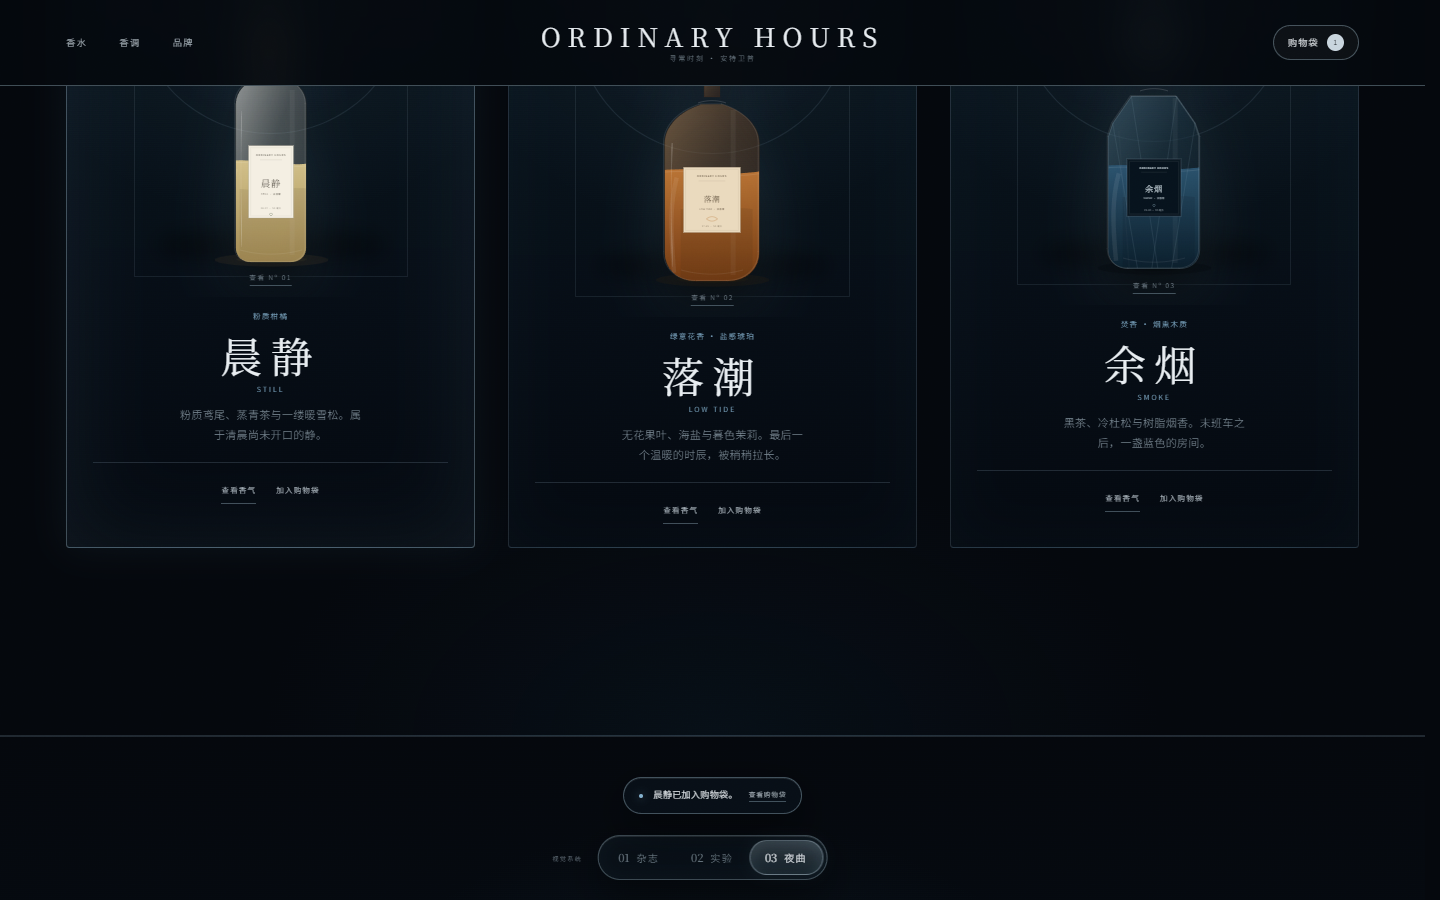
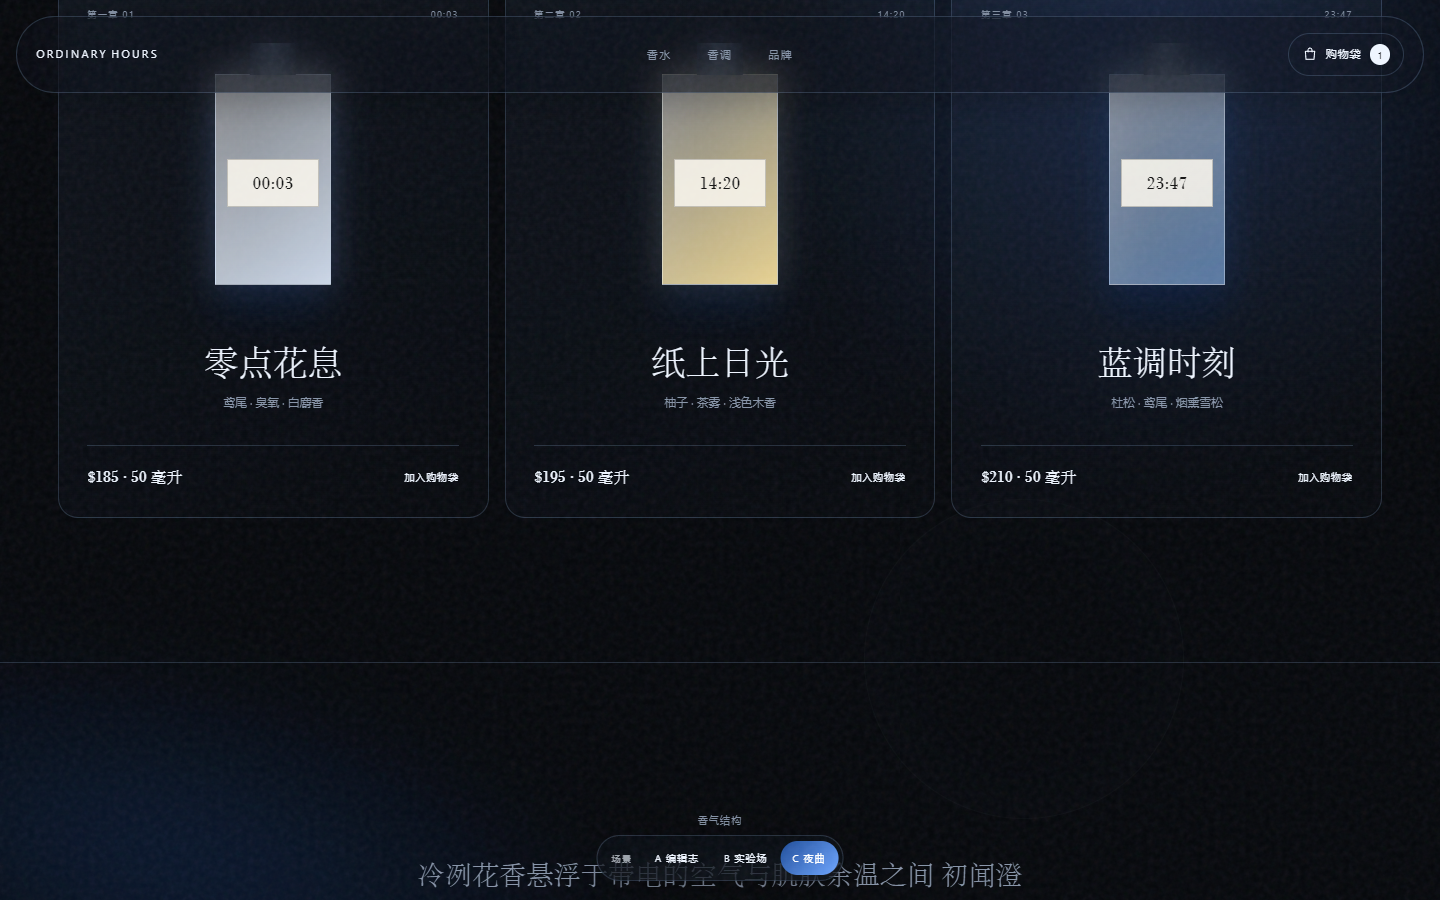
夜曲主题中,两边又转向冷色暗底。DeepSeek 的商品卡片保留了较完整的瓶身细节;GPT 的商品列表使用了更抽象的瓶身图形,与首屏中更精细的香水瓶形成了一定落差。
源码中的切换逻辑也各有处理。DeepSeek 在支持的浏览器中使用 View Transitions API,并为不支持的环境编写了径向遮罩过渡。GPT 同样使用主题属性切换布局,并分别定义字体、间距和组件形态。代码中有兼容处理,不代表所有浏览器都已验证通过。
我实际检查了加入商品后再切换实验、夜曲主题的流程,两边的购物袋数量都保持为 1。打开购物袋,也能看到对应商品。GPT 版的加数量按钮进一步测试后,顶部数量从 1 更新到了 2。
GPT 还将购物袋和主题写入了 localStorage,重新载入页面后保留了之前的选择。DeepSeek 这份文件中的购物袋主要保存在当前页面状态里,重新载入后恢复为空。原题只要求切换主题时保留状态,所以这不构成 DeepSeek 的漏项;GPT 的持久化属于额外完成的部分。
这组作品里,DeepSeek 的三种主题在色彩和商品表现上区分更明显;GPT 也实现了实质性的布局变化,并补上了刷新后的状态保存。两边都完成了主题差异化的核心要求,各有不同的细节。
两边都做到了这道题的重要部分,但“每个转场都无缝”“任何状态下切换都不会出错”仍需要更长时间的操作才能下结论。
第三组 锦鲤池 最容易看出差异的一题
在线体验(新标签页打开):DeepSeek 版锦鲤池 · GPT 版锦鲤池
前两组主要依靠排版、组件和状态管理。这一组需要模型直接用 Canvas 绘制鱼、石头、水面和光影,再让它们动起来。
提示词如下。
请创建一个令人惊艳的、具有真实水下生命感的交互式锦鲤池。

使用单个 HTML 文件,Canvas 2D 和原生 JavaScript,不使用外部库或图片素材。

核心画面:
从正上方俯视一个有自然石头、水下光影和水面波纹的池塘。

池塘中有 6–8 条大小不同的锦鲤,具有白色、橙色、黑色相间的花纹。

核心技术挑战:
1. 每条鱼由连续的身体骨架组成
2. 鱼游动时,身体必须产生沿脊椎传播的真实波动
3. 尾鳍应摆动,胸鳍应有独立动画
4. 转弯必须有惯性,不能瞬间旋转
5. 鼠标移动时鱼群会逐渐靠近,不能简单瞬移
6. 鱼之间应有基本的避让,不能始终互相重叠
7. 鼠标点击水面会产生向外扩散的同心圆波纹
8. 水底有石头和柔和阴影,水面具有动态焦散光影
9. 鱼的游动速度、体型和行为应有自然差异
10. 页面提供暂停、恢复和鱼群数量调节功能

视觉目标:
即使暂停截图,也要有很好的美术表现;播放时则应产生真实、流畅的生命感。

性能目标:
以 requestAnimationFrame 实现动画,合理处理设备像素比与窗口大小变化,桌面端争取稳定在 60 FPS。

适配鼠标与触屏。

不要用简单椭圆加三角形尾巴冒充鱼,也不要让鱼在屏幕中做僵硬的直线漂移。

请直接创建并检查可运行的 index.html。
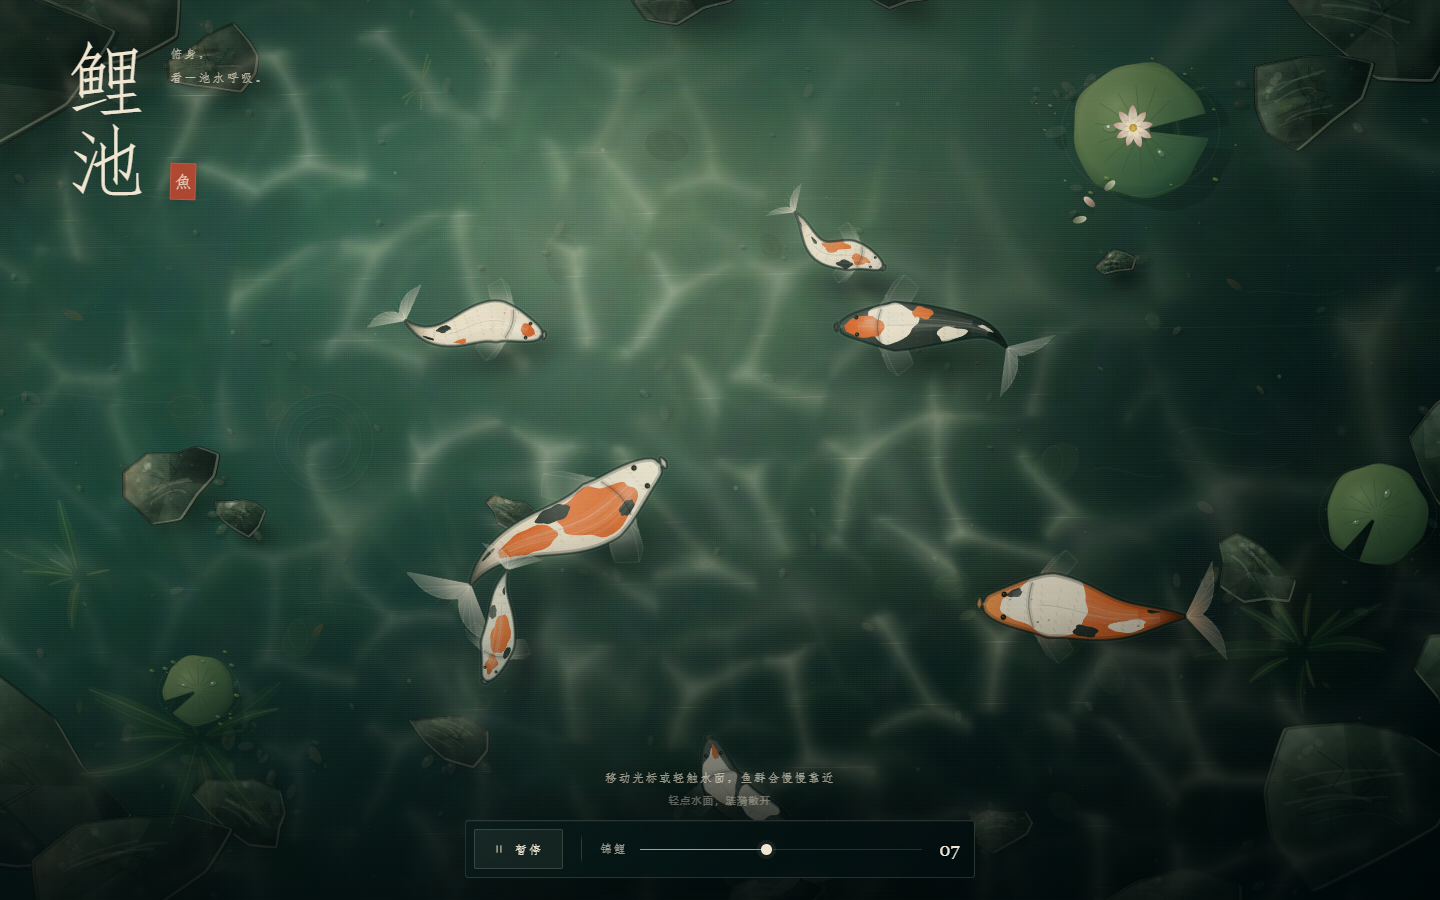
锦鲤池是这次视觉差异最明显的一组,我更喜欢 DeepSeek 的成品。
它选择了偏深的绿色池水,配上不规则石头、荷叶、水草和很明显的水下光影。左上角的竖排“鲤池”和小印章,也与整个画面的方向一致。鱼的身体比较修长,花纹、鱼鳍和表面纹理有更多细节。
GPT 的版本更明亮,蓝绿色水面、圆润的石头、较短胖的鱼,以及底部浅色控制条,组成了一个更接近轻量互动插画的场景。
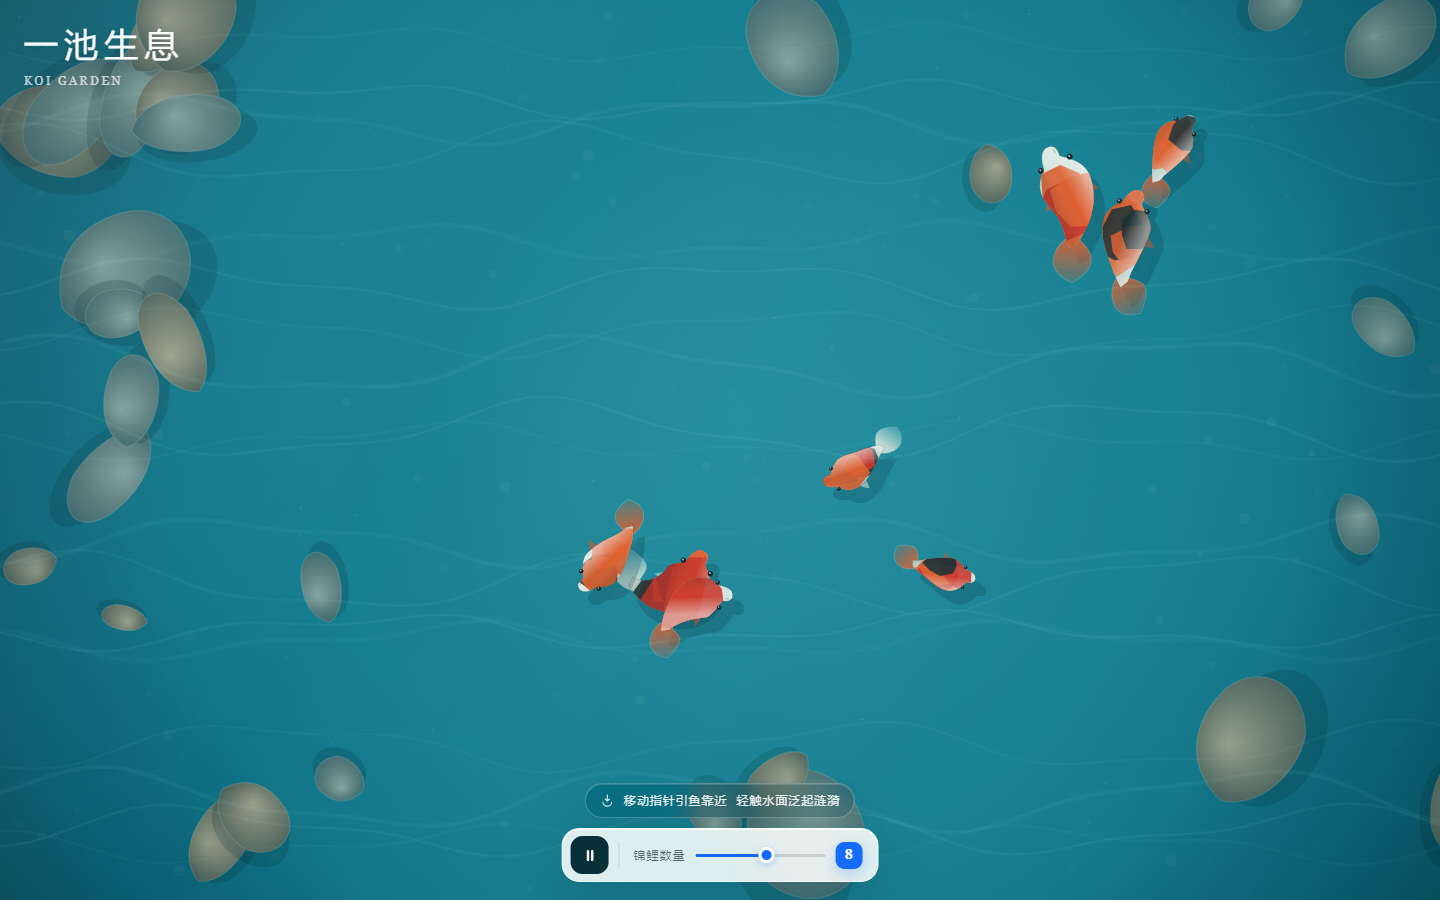
按题目中“真实水下生命感”和“自然石头、水下光影”的要求,我认为 DeepSeek 这份作品更贴题。GPT 的鱼和石头比较简化,水面光影更接近连续的线条装饰。
源码也能解释一部分画面差异。DeepSeek 使用分形噪声生成鱼皮、岩石和池底纹理,并根据像素与邻近采样点的距离生成网状焦散,再做叠加和扭曲。这是一种程序化的视觉近似,不能因此称为完整的光学折射模拟。鱼身骨架会按体型使用约 24 至 35 个节点,绘制细节也更多。
不过,仅凭截图不能评价游动是否自然。我又检查了源码:两边都实现了连续身体骨架、沿身体传播的摆动,以及转向、避让和鼠标吸引的相关计算。GPT 虽然在视觉上更简洁,也确实写了骨架求解,并不是把一张鱼的图形整体平移。
两份作品的暂停按钮都会切换成恢复状态,数量滑块也都能调整到 6。手机视口下,两边都能显示池塘和底部控制区。
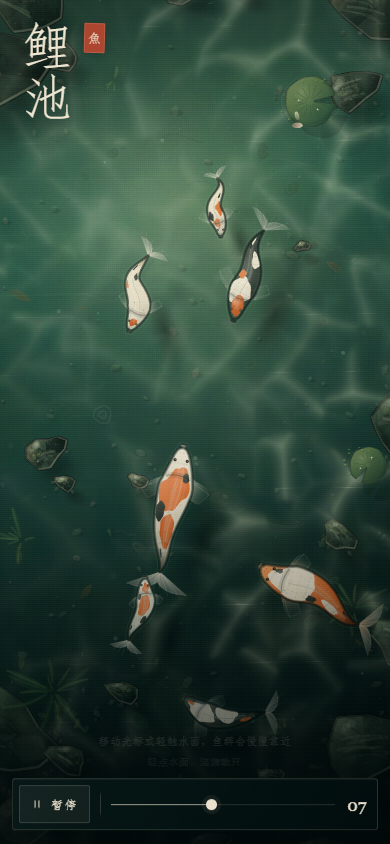
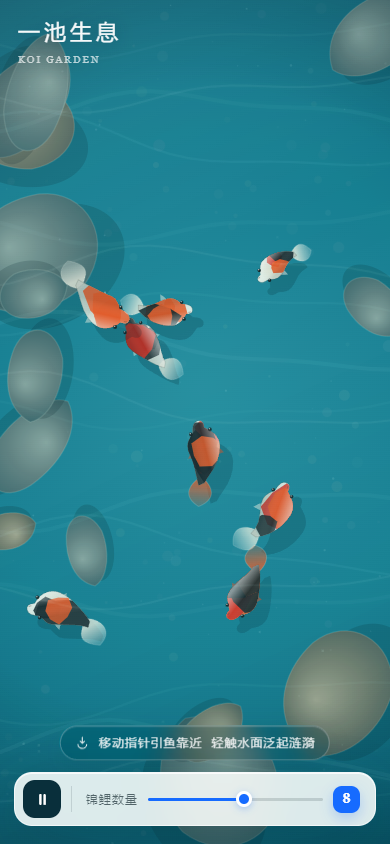
DeepSeek 还写了持续低帧率时降低渲染分辨率的逻辑。这说明它对复杂画面的性能成本做了处理,但不能据此宣称它已经稳定达到 60 FPS。本次没有进行统一时长的帧率记录,也没有检查不同设备的长时间表现。
DeepSeek 在这组任务中呈现了更多相互呼应的场景细节,GPT 则完成了一个表现更简洁的版本。细节数量与算法复杂度解释了部分差异,但作品质量仍应由画面与交互本身判断。
更好的成品 花了多少时间
单看成品截图,DeepSeek 的优势更容易被注意到。加入任务用时之后,两者的差异才更完整。
第一轮会议官网,DeepSeek 先花 39 分钟做出英文版,再用 14 分钟改成中文版,合计 53 分钟。GPT 直接交付中文版,用了 16 分钟。
第二轮香水品牌,DeepSeek 的英文版用了 30 分钟,中文修改又用了 19 分钟,合计 49 分钟。GPT 则是英文版 18 分钟、中文修改 7 分钟,合计 25 分钟。
第三轮锦鲤池,GPT 用了 8 分钟。DeepSeek 运行到 60 分钟还没有完成交付,我打断它,询问是什么情况,之后它才给出结果。因此,这一轮只能记为至少 60 分钟,不能把它写成正常在 60 分钟内自主完成。
三轮合起来,DeepSeek 至少用了 162 分钟,GPT 用了 49 分钟。前者的记录时长至少是后者的 3.31 倍,我多等了至少 113 分钟。
这里的差距包含了语言修改的时间,第一轮两边的流程也不同;它不是对纯推理速度的测量。但对一个等着拿到中文版成品的使用者来说,这些时间确实都要付出。
锦鲤池尤其能体现这次体验的两面:DeepSeek 的画面更合我的偏好,但交付过程明显更长,还需要一次人工介入。
代码中确实存在 window.__koiPond 测试接口,能读取鱼群状态和性能数据。它只能证明页面具备这些检查入口,不能证明模型在后台进行了多少轮测试,更不能据此断言它“陷入完美主义死循环”。本次能确认的是运行到 60 分钟仍未交付,以及我介入后才得到结果;具体原因需要完整执行日志才能判断。
3.5 亿 Token 到底是什么
此前的客户端用量截图中,DeepSeek 面板累计显示 350,705,251 Token,GPT 为 21,323,673 Token,前者约为后者的 16.45 倍。


但展开明细之后,不能把这两个总数理解成模型生成的文字数量。
在这张客户端旧截图中,DeepSeek 输入为 1,748,230,缓存读取为 347,196,796,输出为 1,760,225,缓存写入为 0。缓存读取约占总量的 99.00%。
GPT 的面板中,输入为 436,027,缓存读取为 20,761,600,输出为 126,046,缓存写入为 0。缓存读取约占总量的 97.36%。面板另列推理 Token 27,685;输入、缓存读取和输出三项已经恰好等于总量,因此不在总量上再次加上这一项。DeepSeek 的推理栏显示为 0,也不能单凭这一栏就认定它没有推理过程。
也就是说,大量统计来自缓存上下文的重复读取。它们不等于模型新写出的代码或文字,不能把“3.5 亿 Token”写成“生成了 3.5 亿 Token”。
这两张图是模型累计面板,尚未与三次任务逐一对齐,因此累计值不能直接归入这三次测评。仅凭总量也无法反推出工具调用次数或重写次数:每次请求带入的上下文长度不同,同一个累计数字可以对应很多种执行过程。
为什么叫 Flash 总耗时却更长
单次模型请求的推理速度,与一个开发任务的总耗时并不是同一个指标。总时间还包含多轮请求、工具执行、浏览器检查、修改文件,以及网络和服务端等待。本次记录没有逐项拆分这些时间,因此无法判断哪一项是主要原因,也没有证据排除单次请求速度的影响。
1017 官方说明提到的自反馈强化学习,是模型训练方法的描述。它不等于模型在本次任务执行时持续进行强化学习,也不足以证明它被设计成必须反复重写代码。该说明反而报告了相对上一版缩短运行时间和输出长度的结果。来源:1017 官方更新说明
这里能够确认的是:本次 DeepSeek 交付更慢,早先累计面板记录的输出与缓存读取量也更大。两者之间的具体关系,需要对齐会话记录后再分析。把这直接归因于“8B/16B 激活规模不足,只能用十几倍迭代补偿”,超出了现有证据。
官方性能费用图提供了什么信息
另一张官方图把 DeepSWE v1.1 的通过率(Pass@1)与每任务平均费用放在一起,标注的评测框架为 mini_swe_v2。纵轴越高表示通过率越高,横轴越靠左表示费用越低;横轴采用对数刻度,不能按等距的线性金额来读。
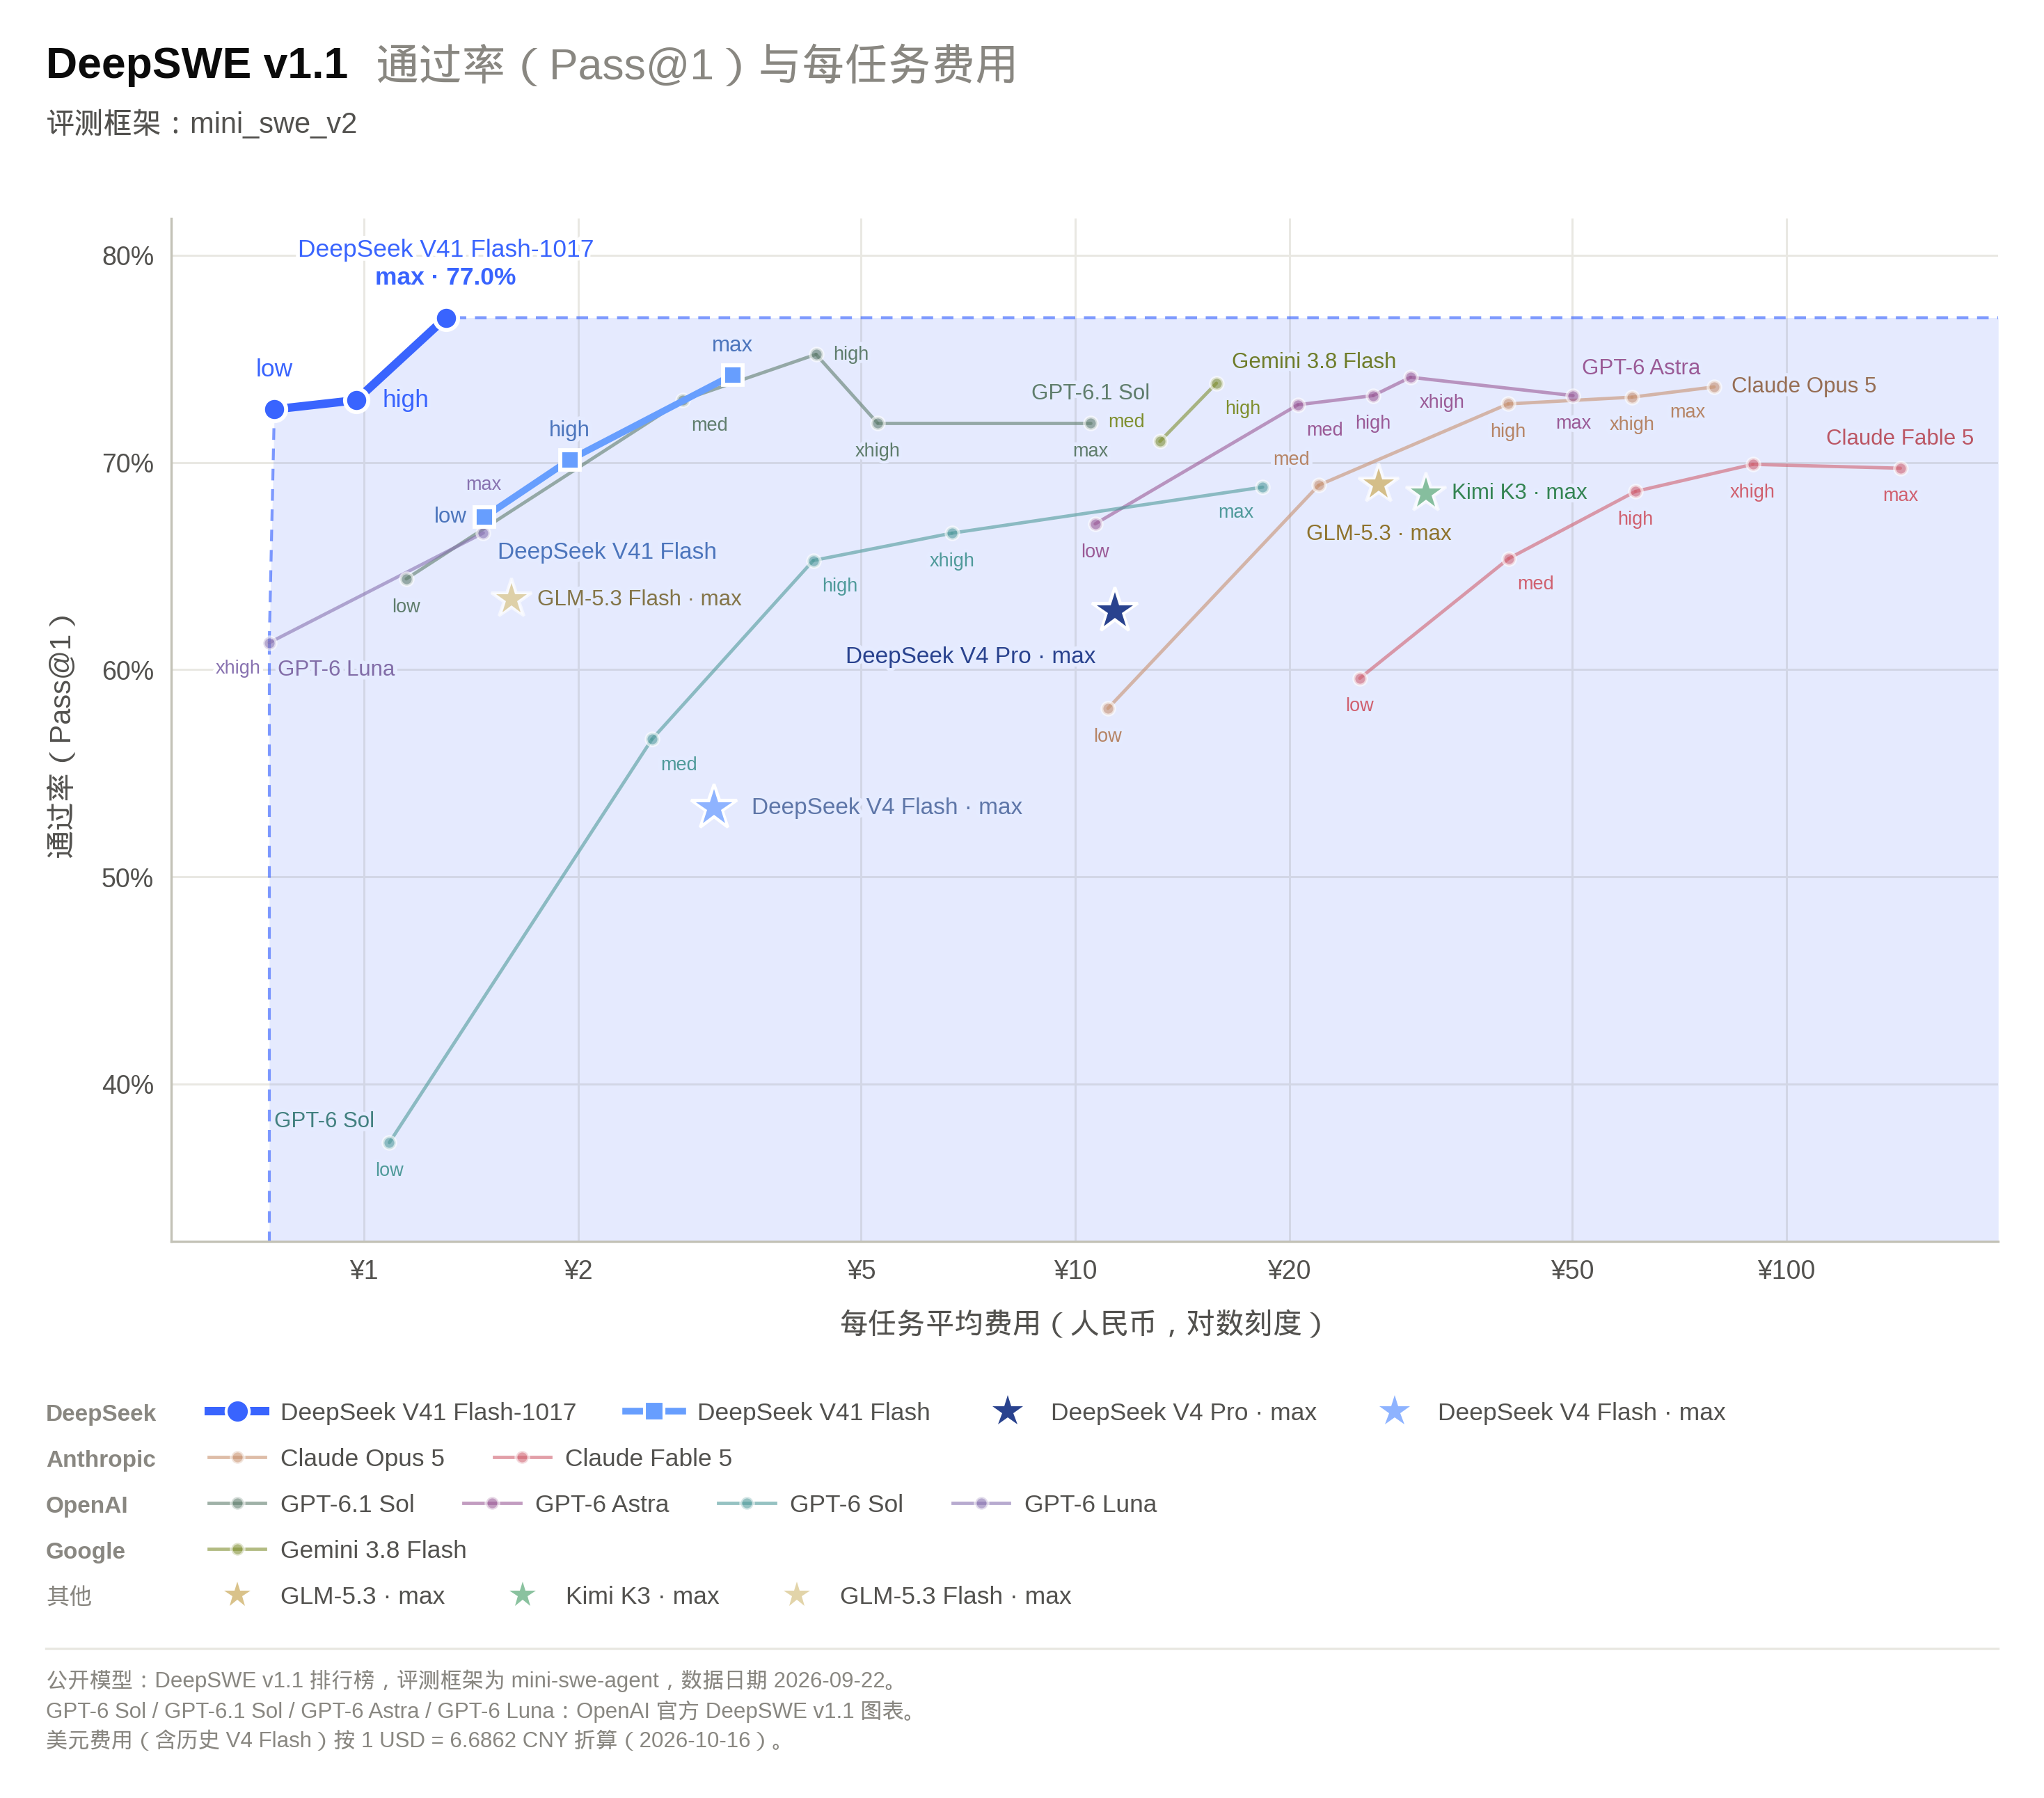
图源:DeepSeek 1017 官方发布说明。图中包含不同推理档位,并在底部注明部分数据来源、日期与美元换算口径。
在这张图里,1017 版 Max 标注为 77.0%,相对旧版 Flash 的 Max 点位更靠左上。这展示了官方所报告的性能与费用改进。需要区分的是,图中 OpenAI 曲线对应 GPT-6.1 Sol、GPT-6 Astra、GPT-6 Sol 和 GPT-6 Luna,没有本文测试的 GPT-5.6 Sol,因此不能用它直接计算本次两款模型的费用差。
此外,这张图没有呈现任务耗时。基准中的每任务费用、本文记录的至少 162 分钟与 49 分钟,以及下面的实际 API 账单,分别回答不同的问题。它提供了官方测试背景,本文的前端作品和时间记录则补充了另一种任务场景下的表现。
按官方 API 账单更新费用
DeepSeek 侧调用的是官方 API,按官方接口价格计费。补充的官方后台截图显示:消费金额 ¥15.97,API 请求 997 次,累计 Token 为 351,441,414。 因此,本文以这张官方后台记录替换先前“约 18 元”的口头估算。
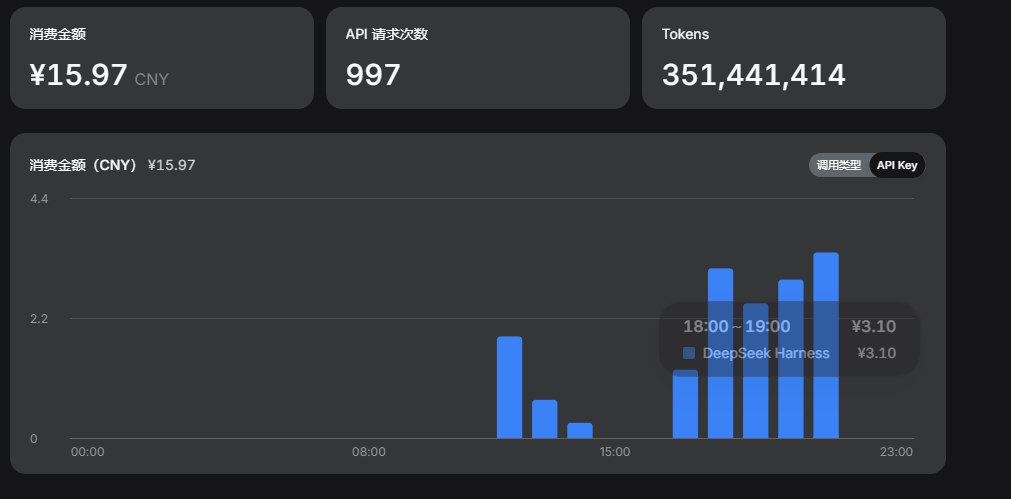
这张图与前面的客户端累计面板不是同一份统计快照:官方后台总量为 351,441,414,客户端旧图为 350,705,251,相差 736,163 Token。旧图仍用于说明其自身的输入、缓存与输出构成,不把旧图各分项直接拼接到新账单上。997 是后台显示的 API 请求次数,不能直接当作工具调用次数、自检次数或代码修改轮数。
按照 2026 年 10 月 19 日核对到的官方价目表,Flash-1017 每百万 Token 的空闲时段价格为:缓存命中输入 0.02 元、未命中输入 1 元、输出 4 元;高峰价格分别为 0.04 元、2 元、8 元。官方规定周末全天属于空闲时段。来源:DeepSeek 官方价格表
缓存命中输入与输出的单价差别很大,这可以解释为什么累计 Token 达到约 3.5 亿,账单仍只有十几元。判断费用需要看用量分类和计费时段,不能将全部 Token 按输出价格相乘。此次消费金额直接采用官方后台的 ¥15.97,不用客户端的美元金额替代。
GPT 侧仍按此前的实际使用记录写为约消耗 75% 的 Plus 额度。客户端显示的 $12.56 没有相应实际扣款账单支持,不作为 GPT 的实际付款金额。DeepSeek 旧面板中的 $4.71 也不再用于人民币费用结论。一个是官方 API 按量消费,一个是订阅额度,两者暂不计算实际付款的倍数差。
这些累计截图没有展示与三次任务逐一对应的起止范围,本文将其作为本次提供的用量与费用记录,保留这一统计范围上的限制。
回到最初的问题 DeepSeek 能否媲美 GPT-5.6 Sol
从这三组最终作品看,DeepSeek 已经展现出与 GPT-5.6 Sol 进行同类前端任务对比的实力。它完成了会议页面、三主题品牌网站和 Canvas 场景,部分视觉细节更丰富;按我的审美判断,锦鲤池的场景表现尤其突出。至少在这组创意前端任务中,“具备可比的成品质量”是有具体作品支撑的。
但成品质量之外,交付过程存在明显差异。DeepSeek 累计至少用了 162 分钟,GPT 为 49 分钟;DeepSeek 第三轮还需要人工介入。两边没有统一时间预算,这意味着本次看到的是不同投入下的最终结果,不能证明 DeepSeek 在与 GPT 相同的时间内也能达到同样的完成度。
官方 API 后台记录的 ¥15.97,也为这次对比补上了费用依据。较低的账单与较长的等待可以同时存在,它们分别描述费用和交付时间,不能互相抵消。
官方基准与这次观察可以同时成立:一个模型在特定基准上得分更高,也可能在另一类开放任务中耗时更长。前者反映该评测设置下的成绩,后者反映本次工作流的实际表现。本文没有复现官方基准,也没有采用相同的 Harness 和推理配置,因此不能用三张网页给全部编程能力下结论。
我的判断是:这次测试支持 DeepSeek V4.1 Flash 1017 在所测前端任务的成品表现上具备与 GPT-5.6 Sol 竞争的能力;交付效率则明显落后于本次 GPT 的实际记录。是否在相同预算下整体达到同一水平,现有证据还不够。
在高端算力受限、“缺卡”成为常态的严苛条件下,国产模型依然能凭借极致的架构创新与工程压榨,硬生生淌出一条路并交出这样的答卷,这让我对国模的未来抱有极大的期待。DeepSeek 这次展现出的审美与代码上限——尤其是锦鲤池中细腻灵动的场景细节,实在令人惊喜;而至少 162 分钟的漫长耗时与第三轮仍需人工兜底的短板,则是它下一步从“能打出惊艳操作”走向“成熟工业级主力”最值得攻克的方向。我很期待在下一次做同样的极限复测时,能看到它在守住高水准作品质量的同时,以更短的等待时间、更高的直出成功率和更少的人工介入,干脆利落地跑完全程。
这份期待也不只属于某一家模型,更属于整个 AI 世界的良性发展。事实上,无论是海内外,无论是坚持技术共享、不断拉高行业基线的开源模型,还是持续探索智能边界、打磨极致体验的闭源模型,我都抱有同样的极大期待。顶尖的突破从不局限于单一路径。开源与闭源模型都可能带来新的能力、效率和使用体验,国产与海外团队也都在探索各自的方向。我期待这些不同的尝试持续推动技术进步,让更多人能够参与 AI 的开发与应用,也让高水平的模型能力变得更加普惠。这次测评让我真切看到了两款模型各自的进步与不足,也让我更想知道:下一次面对同样的考题,它们又会交出怎样的作品?
一个健康的 AI 生态,绝不该是一家独大的沉闷独角戏,而应该是一场既有激烈交锋、又有坦诚交流的群雄逐鹿。我期待看到不同技术路线的团队各展所长、彼此倒逼——用对手的惊艳表现来激发自己的下一次迭代,让用户拥有更从容的选择,也推动更强大、更可靠的智能以每个普通人都能轻松负担得起的成本,真正融入我们的日常创造与生活。无论这些让人欣喜的进步最终来自哪一家模型,我都会由衷地为之高兴。